
使用 Neovim 刷题 LeetCode
预推免
众所周知预推免是有机试的,因此就不得不提前准备一下,否则以我稀烂的算法水平,就算被捞起来那也过于耻辱了。
先来写点别的吧,就是预推免机试本身。因为发的邮件上提到了,原则上我是不能透露机试的题目的,所以我就讲点别的。
先是机试前的准备,记录已经很详细了所以我也不多补充什么了:
2026.9.14
- 之前还想过系统的事情,要不要用 Linux,本来是决定第一次尝试一下,但已经是开着的 Windows 了,那没辙。哦其实早点进去挺好的,可以早点调配系统,我当时有点脑抽了忘了这回事,于是是等到最后一点才进的。
- 那当然就是用 VS Code 了,打开后是一个 C 的目录,我就开始默写模板了。不过其实我当时建了一个
template.cpp想着要的时候再复制,这个没必要,因为我后面直接提前建了题目文件并复制了模板,只是忘记把输入输出一起建了。写的时候还有点忘记了,靠着 LSP 写了ios::sync_with_stdio(false),然后下一句写了cin::tie(nullptr),结果 LSP 报错,运行也不行。后面才搞明白应该是cin.tie(nullptr)。 - 进去的时候本来把 Vim 插件开了,不过很快又关了。因为我好久没配过了,不知道咋搞了,进入 Normal 会习惯
jk,还有一个致命的问题就是剪贴板,想要提交代码的话很麻烦,剪贴板不互通,最后我就放弃了,要换位的时候用鼠标。 - 当时 Code Runner 插件可以直接跑,但我看命令行有点问题,感觉参数有点太少了点,于是尝试去配置。不过因为太久没弄过 VS Code 的 C++ 配置,我也有点淡忘了,折腾了好一阵子,差点没弄完,最后还有几分钟开始的时候才搞定。
- 首先是一个写代码的配置吧,我有点忘记了,但这个还好,直接把标准改成了
c++23。因为我看 OJ 系统,居然支持 C++23,说实话非常意外惊喜。但其实我也没怎么用高级语法,本来用了this推导,但不知道为何还是本地显示有问题,我就不管了直接传self进去。 - 有点忘记了,不知道是前面搞的还是修复后搞的,总之我尝试加过 ASan 参数,也就是
-fsanitize=address,undefined,结果报错找不到,遂放弃。但其实我后面的代码似乎也没涉及边界的处理,所以也用不到。 - 然后主要是那个运行,一直失败,然后我这个报错也看不明白,急死我了,四处改改。不想用 Code Runner 是因为我看它的命令行没什么参数,可能不太符合我的要求,例如说我可能会用 C++20 及以上的语法呀什么的,还有其他的如警告提示等,然后我也没怎么折腾过这个的配置,不清楚怎么设置(虽然后面也尝试看了下设置)。所以说就想用默认的编译运行。
- 不过最后还是发现原因了,原因是用的
gcc而不是g++……因为我 VS Code 打开的这个项目本身是 C 的,配置也是 GCC,虽然我一进来就改了,但其实要改好几个地方,我东改改西改改漏了点,最后才发现有一个二进制文件位置用的是gcc.exe,改成了g++.exe就好了,那时候距离开始也就几分钟了,极限,极限。 - 剩下时间就是尝试 Hello World 了,不过当时有点神经了,发现虽然没报错了,但也没输出,感觉有点诡异。不过很快就发觉了是
freopen的缘故,感觉有点麻烦就把那块注释了。但开考后又启用了,因为真的好方便,我真的要吹爆了。
已经很久没打开过 VS Code 了,但是真到考试的时候那还是会选择 VS Code 的。
南大的 OJ 感觉体验确实很不错,尤其是听说其他地方有断网写代码,然后用 U 盘拷过去运行的情况,就更觉现代化了(好歹没让手写……)。
不过当时更让我惊讶的是直接就上了 C++23,我本地的 C++ 标准也是从一开始的 C++17,到后面为了用一些方便的写法(也同时是学习新语法),一路升到了 C++23。只是其实还是没怎么用,如 Ranges 等。
提前准备的模板如下:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | #include <bits/stdc++.h> using namespace std; using ll = long long; #ifdef LOCAL #define dbg(...) fprintf(stderr, __VA_ARGS__) #else #define dbg(...) ((void)0) #endif int main() { ios::sync_with_stdio(false); cin.tie(nullptr); #ifdef LOCAL freopen("in.txt", "r", stdin); freopen("out.txt", "w", stdout); #endif return 0; } |
第一次用这个 freopen 就是直接在机试上用了,挺好用的。然后就很自然地「三屏」,左边是代码、中间是输出结果、右边是题目,同时还解放了终端可以输出额外的调试信息。
2026.9.14
- 然后就是开始后不久我就能 get 到
freopen了,疑似有点太爽了。之前应该也是分屏,一边题目一边代码,不过其实我自己应该是更习惯左边题目右边代码的,平时练习也是这样的,但这次却是左边代码右边题目,可能也是一开始分的时候就是这样的然后也没有调。然后开始后不久我就再领悟到了,把左边的代码本身再左右分区,右侧放1.out和1.in,常驻显示1.out,因为1.in在编写过程、还没正确的情况下只用弄一下。左侧代码弄大一点,点右侧的时候还会自动扩张,点回去就也会变回去。这样真的好爽,不用反复自己输入或粘贴,而且可以把终端解放出来,显示调试信息。当然我也没把所有样例都弄下来本地保存,实际上测试的时候依旧是每个复制展示一下。虽然说 Linux Bash 有学过一点,但 Windows CMD 那就算了吧。
不过 dbg 倒没有很好用,加上我不太记得格式化字符串怎么写了,就更麻烦了。但这也是没有办法的办法了,毕竟不是本地环境。
2026.9.14
- 在我没搞明白移位的具体情况的时候也有尝试过调试,不过调试我也是标准输入和
dbg一起用,我记得第一题似乎用标准输出更多,然后就是后面自己注释掉,因为bitset嘛,我不太知道格式化该怎么写,就直接用我知道的标准输出了。当然因为我开得比较大,本地上就用宏调小了。不过后面也有问题,因为后面也给了数据很大的样例,本地也在前面通过后调大来检验了,最后就是完全一致。 - 当然其实也可能可以用 C++23 的
print,像是 OJ 上的示例程序就是用这个的。但因为我也不太熟就不敢第一次去尝试,而且也不知道跟前面的关闭同步有没有冲突。***
就浅浅提一下作为一个引子吧。
JetBrains CLion 时期
野望与选择
其实我的算法练习可以追溯到去年这个时候。说早吧挺早,说晚吧挺晚。
说晚是因为入学的时候我没练算法,上课的时候我没练算法,考试的时候我没练算法,结果等到《数据结构与算法》课都上完挺久了,才做了我的 LeetCode 第一题。
挺早[1]则是相对当前的时间节点,以及我最初的「预想」算比较早的了。我那会也是因为有了一些紧迫感,被焦虑推着去计划了下算法练习。
2025.9.5
- 下午 *** 聊了下他们那保研的事情,***
- 于是乎一下午查了一下保研有关的资料,现在大致算是知道怎么运作了。
- 然后就感慨绩点没啥用。***
- 但是重中之重其实是后面的内容,即使推免了,后面还有笔试、机试、面试什么的。
- ***,机试和面试可以说是直戳我命门。机试我太紧张和犯低级错误了,练得也比较少,因为我不太喜欢算法吧。面试就更不用说了,哥们我还没面试过呢,更别说其中可能的英文了。
- 唉,行路难。我觉得这学期还是练一下算法吧,毕竟写代码真的太少了,项目不做,总得写点代码。
以及当时退课的期望:
2025.9.7
- 退掉了,希望以此换来的是这学期能练一下算法。大概算了一下学分应该问题不大,实在不行大四上学期应该也能补完。
写到这想起来个有意思的事情,截至目前,大学前三年我一共修了 149.5 学分,算上大四一年的两次形策课就正好凑齐 150 学分了。不过其实还有毕业设计的 6 学分会打破这个完美的数字。
然后 2025.9.10 我就基本是完成了我的 LeetCode 第一题(各种意义上)。
当时练习 LeetCode 一共有两个选择,一个是 VS Code,一个是 JetBrains CLion。从子标题上看可以知道我当时选择的是后者,不过如果是现在的我穿越回去的话也许更倾向前者。
我当时的想法大约就是,这两个机房都会提供(不过现在我其实并不确信了,当时会这样想也是受到了自己所处四周环境的影响),CLion 作为一个重型 IDE,功能应该还是比(没有定制化配置过的)VS Code 要全面与强大的。此外还有一个在当时比较重要的原因就是,我认为 CLion 的 Vim 插件比 VS Code 的要好用一点。
现在看来其实还是比较荒谬的理由。前者,VS Code 在 LSP 的帮助下其实也差不了多少,虽然没有 Clangd 插件,因此体验上还有些许差距;而后者,再怎么配,终究也是残次品,尤其是它不会默认把剪贴板配好,导致如果想要获得一个比较好的体验的话,那就得记一下配置,然后在机房里慌慌张张地配置。要是偶然忘了,那就得提交的时候记事本打开来复制一下了。这些都是亲身经历,所言非虚。
当然 CLion 也有它的调试器?虽然我有点忘了什么样子了,但 VS Code 根据使用的记忆差距大概也并不算大。加上根据我自己练习的经历,用调试器还是太少了,都是靠其他方式(打印)进行调试的。正好前几天看到 Rust debugging survey 2026 results | Rust Blog,使用频率上打印调试是毋庸置疑的第一。
反而是 CLion 的内存占用对我的轻薄本来说,确实是一大不可忽视的负担。
由于我已经卸载了 CLion,没法第一手地拿到相关配置,因此只能通过一些旧纪录进行回顾。
出发
我当时使用的应该是 leetcode-editor Plugin for JetBrains IDEs | JetBrains Marketplace 这个插件,因为选择了 CLion,也是在 Windows 上进行练习,毕竟一个 JetBrains 已经是内存巨兽了,再活跃个 WSL 也吃不消。
最初的配置大概就是 CLion 的默认配置吧,具体可见初始化的提交 25b9edd,大概就是配了 .clang-format, .clang-tidy 等,使用 CMake 管理(尽管我不会写 CMakeLists.txt),最初的版本也是 C++17,以及忽略了爬取的题目信息(即 doc)。
最初还准备了一个 utils.h,当时大概就有了优化本地调试体验的想法。最初只有一个函数 printVector,用于调试 vector:
1 2 3 4 5 6 7 8 | template<typename T> void printVector(const vector<T>& vec) { cout << "["; for (int i = 0; i < vec.size(); ++i) { cout << vec[i] << (i == vec.size() - 1 ? "" : ", "); } cout << "]" << endl; } |
根据第一题的样子,大致也可以了解到我当时写题目的方式:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | // 2025-09-10 17:49:33 #include <bits/stdc++.h> using namespace std; //leetcode submit region begin(Prohibit modification and deletion) class Solution { public: vector<int> twoSum(vector<int>& nums, int target) { unordered_map<int, int> table; for (int i = 0; i < nums.size(); i++) { auto result = table.find(target - nums[i]); if (result != table.end()) { return {result->second, i}; } table[nums[i]] = i; } return {}; } }; //leetcode submit region end(Prohibit modification and deletion) #include "../../../utils.h" int main(void) { Solution s; vector<int> t1 = {1, 2}; s.twoSum(t1, 3); return 0; } |
上面的区域称为 Import 区。最上面标记了时间,然后使用了万能头,并将 std 命名空间内容直接引入。
最下面的区域就是 Main 区,因为 LeetCode 风格的练习与 ACM 风格不一样,ACM 风格要求自行处理输入输出,而 LeetCode 风格的题目(大多)输入输出格式以函数签名的形式给出,这免去了自行处理输入输出的琐碎事。当然,自然也就缺乏了处理输入输出的学习与经验。
因此 LeetCode 风格的题解基本上是以 Solution 类的格式表示,若需要本地运行调试,就需要自己准备一个 main 函数了。
总之,9.10 开始,就开始了正式的,我的第一小段机试练习。
毕竟还是要上课,所以最初的计划也就是一周抽个几天的早上练一下得了。
2025.9.12
- 昨天的时候大致想过,算法安排是跟 *** 一致,周三、五、七,***。暂时是这样想的,这两天整个晚上做项目,是自己的项目,例如说 Focust 之类的。
写着写着就会遇到新的情况,于是就为工具函数添砖 Java,如加入了 printMatrix 打印矩阵。
后面我又觉得可以继续进行改进,记得大约是与 DS 进行了交流。STL 容器中除了 vector 外还有一些也可以加上打印的支持。此外用 printVector 什么的还是太麻烦了,遂直接实现了 << 操作符。
同时像上面的例子,我要测试的时候不得不 vector<int> t1 = {1, 2} 这样,写了几次后就倦了,能否直接写在调用里面呢?在上面也进行了支持。当然这是十分危险的,因为很多题目签名传入的都是其引用,而直接在调用处构造又没有命名绑定,很容易造成悬垂引用。不过只要约束自己、知道自己在干什么倒也还好了。
这样子后就可以直接 s.twoSum(VEC(1, 2), 3) 了,很是方便。当然也加入了如 VECSTR, MAT 等,用于其他情形。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | template<typename T> class LValueVec { public: std::vector<T> data; LValueVec(std::initializer_list<T> il) : data(il) {} operator std::vector<T> &() { return data; } }; template<typename T> std::ostream &operator<<(std::ostream &os, const LValueVec<T> &lv) { os << lv.data; return os; } //! 用以方便地对非 const 的 vector<T>& 的函数参数进行传递。 //! 这可能会造成危险的悬垂引用,慎用! //! 不应修改或引用这样传入的临时 vector。 #define VEC(...) LValueVec<int>({__VA_ARGS__}) #define VECSTR(...) LValueVec<std::string>({__VA_ARGS__}) #define MAT(...) LValueVec<std::vector<int>>({__VA_ARGS__}) |
后面还有 string 与 vector<char> 之间的转换 S2V, V2S等。
做到链表的时候,反复抄注释里面给的定义我也是烦了。于是后面也将其写入了 utils.h 当中,同时也加入了一些辅助调试的工具函数,如可以用链式的 tree->visualize() 开启可视化打印,直观呈现树的形状。从代码中还能看出来为了应付 Windows 终端编码问题,而在代码中设置为 UTF-8 编码,确保树的形状完美地呈现。
整理与笔记
不过当时练习的习惯其实非常差劲,早些时候还会看看题解,等到后面的时候就是过了得了,也不管是不是最优解、代码写得好不好。因此其实也没学到什么。
2025.9.14
- 记得整理,有一些解法确实不太好。
于是我打算需要文档记录一些题解和想法,这样才能更好地学习与理解记忆。
2025.9.15
- 晚上稍微弄了点算法周报的模板,但是未完成,待继续。
我很沉浸于为达最初计划目的地时铺设地砖的过程,往往乐在其中,超过了向目标进发。当然,这个过程基本上也是伴随着拖延,墨迹。
2025.9.21
- 算法模板极限,晚上很晚才开始认真投入弄,现在就差 Bases 了。
下面是我最终准备的笔记模板:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 | <%* const LeetCodeManager = tp.user.LeetCodeManager; const AlgorithmProblem = tp.user.LeetCodeAlgorithmProblem; const problem = await new AlgorithmProblem(tp, LeetCodeManager).create(); %>--- aliases: - LeetCode <% problem.formattedId %> tags: - 算法/LeetCode <%* problem.tags.forEach(tag => { %> - 算法/标签/<% tag %> <%* }) -%> leetcode_problem_id: <% problem.id %> leetcode_title_slug: <% problem.title_slug %> leetcode_title: <% problem.title_cn %> leetcode_difficulty: <% problem.difficulty %> leetcode_source: <% problem.url %> leetcode_creation_time: leetcode_finish_time: leetcode_time_use: leetcode_independent_solution: true # true|false creation_time: <% problem.creation_time %> update_time: <% problem.creation_time %> leetcode_problem_status: 进行中 # 进行中|已完成|待复习 --- # 📝 [LeetCode T<% problem.formattedId %>:<% problem.title_cn %>](<% problem.url %>) > [!ABSTRACT] 核心摘要 > - **核心问题**:用一句话重新描述题目,萃取出问题的本质。 > - **核心思路**:一句话点明解题用的核心算法模式或数据结构。 > - **关键逻辑/状态转移**:DP 题写状态转移方程,回溯题写决策树模型,双指针写指针移动逻辑等。 > - **关键点/易错点**:边界条件、特殊 case、优化技巧等。 > - **复杂度**:时间和空间复杂度。 > [!INFO]+ 具体题目 > ![[<% problem.description_filename %>]] |
模板本身很简单,关键其实在于其内核,也就是 LeetCodeManager 与 LeetCodeAlgorithmProblem。下面是相应的接口,完整代码就不放了:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | class LeetCodeManager { constructor(tp) {} /** * 异步加载和解析题目数据库 JSON 文件。 * 使用缓存机制,只有在数据未加载时才读取文件。 * @returns {Promise<boolean>} 如果成功加载则返回 true,否则返回 false。 */ async #loadProblems() {} /** * 格式化题号,确保为 4 位,不足则补零。 * @param {string|number} id - 题目ID. * @returns {string} - 例如,1 -> "0001", 123 -> "0123". */ formatProblemId(id) {} /** * 根据题目 ID 获取题目详细信息。 * @param {string|number} id - LeetCode 题目的编号。 * @returns {Promise<object|null>} 返回题目信息对象,如果找不到则返回 null。 */ async getProblemById(id) {} /** * 根据题目信息生成标准的文件名。 * @param {object} problem - 从 getProblemById 获取的题目对象。 * @returns {string} - 标准化的文件名,例如 "LeetCode-T0001-TwoSum.md"。 */ generateProblemFileName(problem) {} } |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | class LeetCodeAlgorithmProblem { constructor(tp, LeetCodeManager) {} /** * 通过 LeetCode GraphQL API 获取题目的详细描述(中文)。 * @param {string} titleSlug - 题目的 title_slug,例如 "two-sum"。 * @returns {Promise<string|null>} 成功则返回 HTML 字符串,否则返回 null。 */ async #fetchProblemDescription(titleSlug) {} /** * 生成描述文件的标准文件名。 * @param {object} problem - 题目对象。 * @returns {string} - 描述文件名,例如 "0001-Two-Sum-Desc.md"。 */ #generateDescriptionFileName(problem) {} /** * 创建单个题目复盘笔记的核心函数。 * @returns {Promise<object|null>} 返回包含题目信息的对象,用于模板填充。 */ async create() {} } |
然后创建出来的笔记模板大概就是下面这样:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | --- aliases: - LeetCode 0002 tags: - 算法/LeetCode - 算法/标签/递归 - 算法/标签/链表 - 算法/标签/数学 leetcode_problem_id: 2 leetcode_title_slug: add-two-numbers leetcode_title: 两数相加 leetcode_difficulty: 🟠 Medium leetcode_source: https://leetcode.cn/problems/add-two-numbers/ leetcode_creation_time: 2025-09-24 20:12 leetcode_finish_time: 2025-09-24 20:39 leetcode_time_use: 27min leetcode_independent_solution: true creation_time: 2025-09-27 16:37 update_time: 2025-09-27 16:37 leetcode_problem_status: 进行中 value: density: --- # 📝 [LeetCode T0002:两数相加](https://leetcode.cn/problems/add-two-numbers/) > [!ABSTRACT] 核心摘要 > - **核心问题**:用一句话重新描述题目,萃取出问题的本质。 > - **核心思路**:一句话点明解题用的核心算法模式或数据结构。 > - **关键逻辑/状态转移**:DP 题写状态转移方程,回溯题写决策树模型,双指针写指针移动逻辑等。 > - **关键点/易错点**:边界条件、特殊 case、优化技巧等。 > - **复杂度**:时间和空间复杂度。 > [!INFO]+ 具体题目 > ![[LeetCode-T0002-AddTwoNumbers-Desc]] |
当时大概就是做一道题,然后就去创建一个这样的笔记,并填入诸如时间这样的元信息。
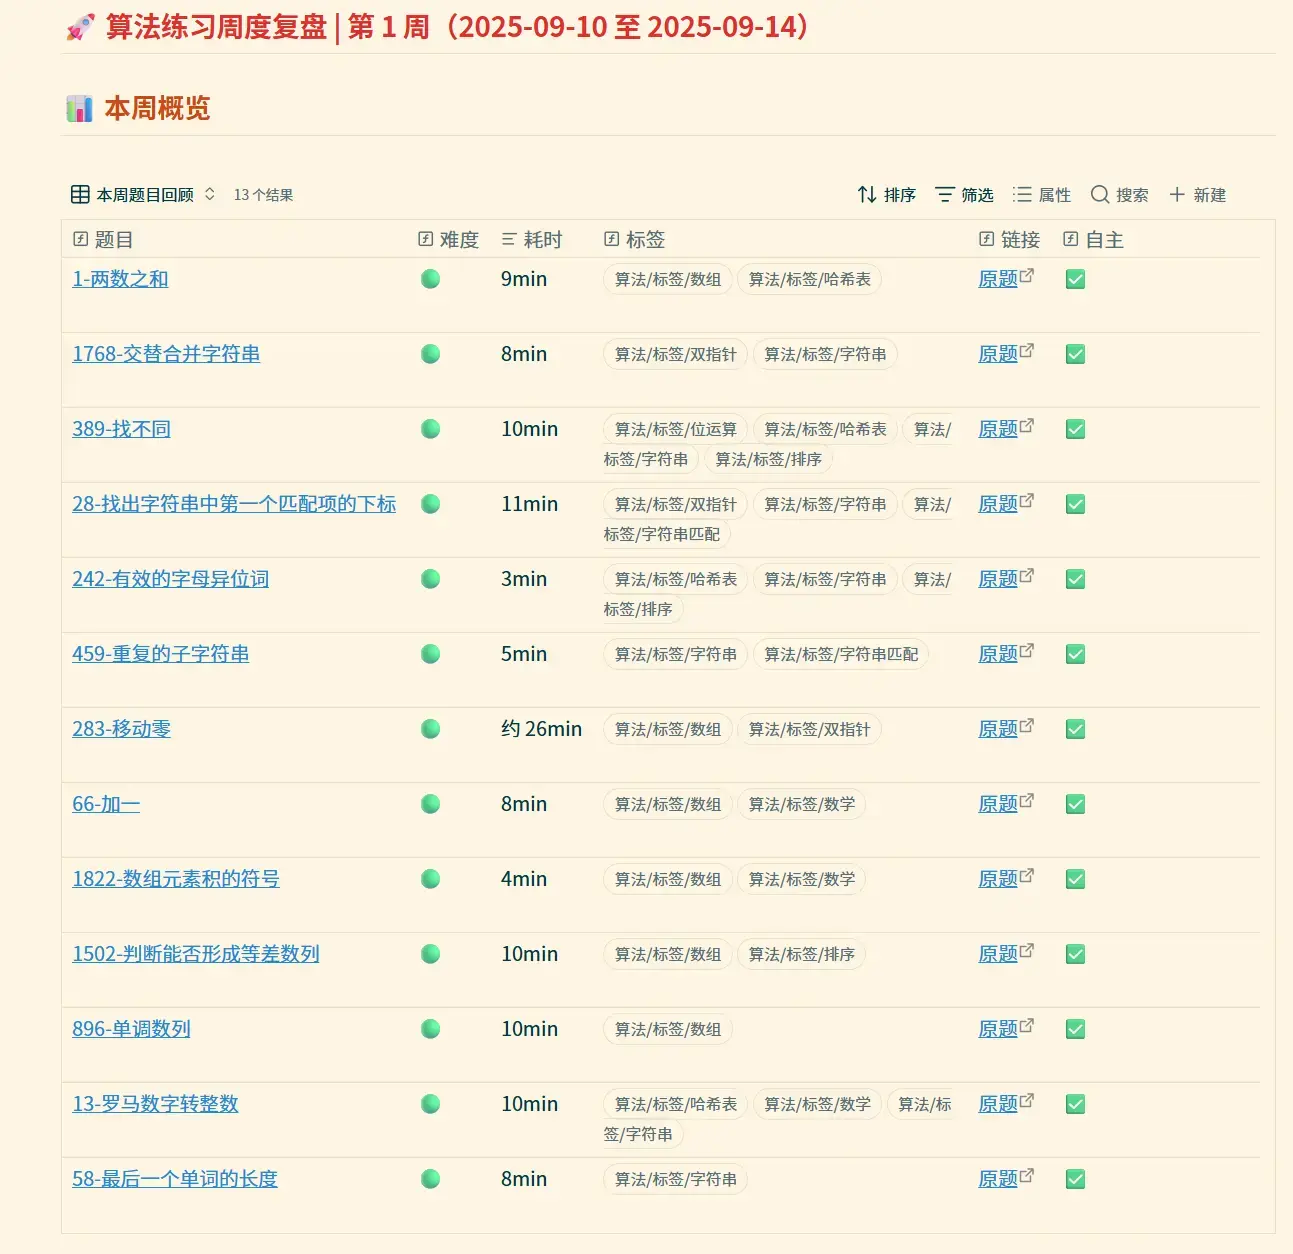
还准备了一个「周报」,下面是相应模板与 Bases 代码,用于统计一周内做的题:
2025.9.24
- 一个个将之前做的题目建立了复盘文件,累死了。
- 除了一道题目创建和完成时间不是同一天外,其他的用时都比较精准。因此后面要是没做完、不打算当日继续做、且最多只是完成了数据读取、构造等初级,并未涉及逻辑部分的话,直接到时候删掉重做。要是单纯因为一天做不完,直接写时间 1h+ 就行了。
- 后面大概就是做一道立刻搞一道,或者是一天完后立刻弄。
- 弄每周的时候才发现原来 Bases 的 filters 少写了一个 s……
- 此外还有一个,完成时间字段多了个 HH-mm,结果它就认为比
week_end大了,超出了范围。解决方法就是先 format 成 YYYY-MM-DD 再date()。 - 感觉算法题 Bases 有点卡,这才几道题啊……
- 代码写错了,结果造成了
.md.md的局面。本来是想取消创建或创建失败时去除该文件的,但看来 Templater 不太可行?硬来的话应该可以通过tp.app,但我懒得折腾了,尽可能避免取消创建和创建失败吧。我先加个 gitignore。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | --- tags: - 算法/每周回顾 leetcode_problems_solved: 347,144,145,94 leetcode_problems_count: 4 leetcode_practice_week: 7 week_start: 2025-10-20 week_end: 2025-10-26 creation_time: 2025-10-26 20:07 update_time: 2025-10-26 20:07 value: density: --- # 🚀 算法练习周度复盘 | 第 7 周(2025-10-20 至 2025-10-26) ## 📊 本周概览 ![[LeetCode-Problems-Summary.base]] ## 🔍 题目解析 ![[LeetCode-T0347-TopKFrequentElements]] --- ![[LeetCode-T0144-BinaryTreePreorderTraversal]] --- ![[LeetCode-T0145-BinaryTreePostorderTraversal]] --- ![[LeetCode-T0094-BinaryTreeInorderTraversal]] |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 | filters: and: - file.hasTag("算法/LeetCode") formulas: problem_title: link(file.asLink(), leetcode_problem_id + "-" + leetcode_title) problem_difficuly: leetcode_difficulty.slice(0, 2) is_independent: if(leetcode_independent_solution, "✅", "❌") source_link: link(leetcode_source, "原题") problem_tags: file.tags.filter(value.startsWith('#算法/标签')) properties: formula.problem_title: displayName: 题目 formula.problem_difficuly: displayName: 难度 formula.problem_tags: displayName: 标签 formula.source_link: displayName: 链接 note.leetcode_time_use: displayName: 耗时 formula.is_independent: displayName: 自主 views: - type: table name: 本周题目回顾 filters: and: - date(leetcode_finish_time.format("YYYY-MM-DD")) >= date(this.week_start) - date(leetcode_finish_time.format("YYYY-MM-DD")) <= date(this.week_end) order: - formula.problem_title - formula.problem_difficuly - leetcode_time_use - formula.problem_tags - formula.source_link - formula.is_independent sort: - property: leetcode_finish_time direction: ASC rowHeight: medium - type: table name: 总题目回顾 order: - formula.problem_title - formula.problem_difficuly - leetcode_time_use - formula.problem_tags - formula.source_link - formula.is_independent sort: - property: leetcode_finish_time direction: ASC rowHeight: medium |
显示效果:
笔记之后就是 Anki 了,我也萌生了使用 Anki 辅助记忆的念头。
2025.9.27
- Anki 也可以用于算法练习记忆,不过应当设置得比较简练才行。
- 我在想能不能综合一下题解,在题解一部分用一定规则写下比较短的核心总结,然后可以用脚本填充其他字段快速制卡。毕竟题干部分是没有在模板中的,需要额外写程序规划。这可能要开始写点题解后进一步思考。
不过上面的这个思考,最后不断推迟,在今年三月的时候才在「程序」上取消了。
结局
然后可以快进到结局了。上面的笔记,除了最开始的测试用途外,一次也没写过,「光荣」地成为了我的无用功之一。
此外我这一阶段的算法练习也最终停在了 2025.10.22,在那天进一步更新了工具函数后,再也没用到更新后的内容了。
翻了一下那会的记事,结合这个时间节点,毫不意外啊只能说——我去搞 Focust 了。名义上就是暂停一阵子算法练习,实际上那段日子整个生活都暂停了。一直到非常久了后,才最终在名义上也停止了。翻看记录,这个「非常久」是 2025.11.23。
这一阶段的算法练习,除了给我折腾扑通了几下子外,似乎也确实没产生什么实际的意义。毕竟题目也是瞎糊弄的,过了就过了,也没有看题解去理解和改进写法。笔记更是徒有一个模板,没有任何产出。
寒假的时候也久违地想到了算法,不过最终是毫无动静,下面便是唯一的记录了:
2026.2.2
- 要准备一下日程了,寒假还是练练算法比较好。
类似的故事在大三下学期也有上演。三月份开学的时候也是想到,是时候捡起来算法练习了,那会提升了 Anki 的优先级——也可能是因为代码部分实际上已经比较完善了——在思考着笔记与 Anki 之间的整合,毕竟我一点也不想每道题笔记写一点,然后 Anki 制卡还要再写一点。这期间产出了一些文档,包含规范与一些速查表等,我记得是有两份多篇,但我也一直没来得及看,就放在我的「下载」文件夹,直到今天才删掉。恢复看了两眼,感觉也挺一坨的。
于是又是一晃头,一学期又要过了,临近期末,我又觉得是时候考虑恢复一下算法练习了,差不多是 2026.5.11 那会。结果重新启动的任务待办,被一次又一次取消,最后在过了一个月后的 2026.6.9 后,又一次终止了。这一次,一题都没做。
Neovim 时期
以下内容最新基于 3ea53cb。
灵感?
当然,上面的内容都不是本文的正题,尽管已经有了五千多字。毕竟本文的标题是「使用 Neovim 刷题 LeetCode」,Neovim 还没出现呢。
最初的念头是在期末考试复习的最后关头出现的,当时不想复习,灵光乍现有了念头,记录了下来。
2026.6.28
- 唉,这个软件质量管理是真不想背,中午也没回去午休,继续摆,到现在三点半才来写,写完后继续背吧。
- 昨天的时候想到,七月的时候可以试试用 Neovim 做 LeetCode,就不必用笨重的 CLion 了。找到了一个 Neovim 插件可以满足,有其他的需求也可以到时候 fork 改改。另外还有一个问题是注意到 gr 映射重复了,按理来说 gr 开了一个组,不过现在立刻触发了。
很快啊,gr 这个在考完试后几天就搞掉了。大概就是 Neovim 0.12 提供了 gr* 的默认 LSP 映射,不过我用 LazyVim 已经有了且习惯了其他的映射(且功能大概更强),于是就删掉了。具体可见 |lsp-defaults|。
还有上面的提交还将之前 Vim 的 <leader>o/O 映射——也就是不改变光标位置向下/上插入一个空行——改为了 <leader>oj/k,虽然说到现在还不是很习惯,但也是为了映射的命名空间着想。前者 o 和 O 的命名空间就直接废了,而后者还有大把的映射空槽可供考虑。
不过与其说这个阶段在准备用 Neovim 刷 LeetCode,不如说是在我自己在调配着 Neovim 玩。看了相当多插件的文档并实际测试与调整配置,玩得很开心。
崭新的仓库
既然抛弃了 CLion 而转向 Neovim,自然也可以使用 WSL 了,不用被 Windows 折磨。
七月初我经过与 Agent 深入的交流,规划并重新设计了一下题解仓库的形式。
在之前,根目录散落着一些文件,而题解本身是在 leetcode/editor/cn 中,这似乎是插件配置上的原因。迁移后题解本身就在 solutions 中,也更加清晰了。
调试层面
此外,之前单一的 utils.h 也被我拆分为了多个工具库,并进行了大面积的扩展。utils.h 只承担「重导出」的职责,具体的任务被拆解在 lc/ 子目录中(含义为 LeetCode)。
1 2 3 4 5 6 7 8 9 | #pragma once #include <bits/stdc++.h> #include "lc/check.h" #include "lc/dbg.h" #include "lc/nodes.h" #include "lc/parse.h" #include "lc/print.h" |
具体而言,拆分为了 check, dbg, nodes, parse, print 这五个部分。
nodes 部分就不用说了,其实就是给予链表、二叉树定义。特别地,LeetCode 样例中的二叉树给的是其层序遍历表示(含空节点),中间可能会有 null 的存在,于是提供了 vector<optional<int>> 的转换方式。当然,也继承了我之前的 tree->visualize() 链式开关打印。
print 部分也很简单,同时使用了 C++ 的一些模板语法,可能还有 concepts 等,简化了写法,不用像我之前每种容器的模板写一次了。
然后是 check 部分。之前本地判断正误我都是手动执行并肉眼对比输入输出。但是我觉得这样还是太累了,于是就准备了这样一个工具库,将调用与预期结果直接写在 main 中,执行后就会自动判断正误,如果不同也会显示出来。具体而言其实现方式是,将输出转换为字符串,然后进行对比,找到第一个不同的地方。
提供了下面的宏方法:
1 2 3 4 5 6 | CHECK(actual, expected) // 基础比对 CHECK("demo", actual, expected) // 带用例标签(下面的版本也有) CHECK_ANYORDER(actual, expected) // 排序后比对(任意顺序均可的题) CHECK_INPLACE(call, modified, expected) // void 函数改引参:先调用后比对 CHECK_FIRSTK(k_call, vec, expected) // 返回 k、取前 k 个比对 CHECK_FIRSTK_ANYORDER(k_call, vec, expected) // 前者的任意顺序版(后面添加的) |
除此以外,还有中间的调试。打印就是最好的调试,但是 C++ 很多类型默认没法打印,或者打印的形式不符合预期。因此 dbg 还提供了一个 DBG 宏,用非常自然的形式对中间变量进行快照。
下面 utils.h 回归测试与其输出(有修改),DBG 宏的输出是在 stderr 中,而 CHECK 则是在 stdout 中。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 | #include "../utils.h" int main() { /* --- parse.h:UDL 字面量 --- */ CHECK("[1,3,-1]"_vi, std::vector<int>{1, 3, -1}); CHECK("[[1,2],[3],[]]"_vvi, std::vector<std::vector<int>>{{1, 2}, {3}, {}}); CHECK(R"(["ab","c"])"_vs, std::vector<std::string>{"ab", "c"}); CHECK("[1.5,2]"_vd, std::vector<double>{1.5, 2.0}); CHECK("[true,false]"_vb, std::vector<bool>{true, false}); CHECK("[]"_vi, std::vector<int>{}); CHECK("abc"_vc, std::vector<char>{'a', 'b', 'c'}); /* --- 链表/树:构造与打印一致性 --- */ CHECK("[1,2,3]"_list, "[1,2,3]"_list); CHECK("[]"_list == nullptr, true); // 空链表语义:nullptr CHECK("[1,null,2,3]"_tree, "[1,null,2,3]"_tree); CHECK("[]"_tree == nullptr, true); /* --- print.h:泛型容器 --- */ CHECK(lc_check::stringify(std::deque<int>{1, 2}), "[1, 2]"); CHECK(lc_check::stringify(std::map<int, int>{{1, 2}}), "[(1, 2)]"); CHECK(lc_check::stringify(std::make_tuple(1, 'a')), "(1, a)"); CHECK(lc_check::stringify(std::optional<int>{}), "null"); CHECK(0.1 + 0.2, 0.3); CHECK(1024.0, 1024); // 混用整型不因序列化格式差异误报 CHECK(lc_check::stringify(2.0), "2.00000"); /* --- check.h:标签 / anyorder / inplace / firstk --- */ CHECK("labeled case", 1 + 1, 2); CHECK_ANYORDER(std::vector<int>{3, 1, 2}, "[1,2,3]"_vi); CHECK_ANYORDER("anyorder labeled", std::vector<int>{2, 1}, "[1,2]"_vi); auto v = "[0,1,0,3,12]"_vi; auto move_zeroes = [](std::vector<int> &nums) { std::stable_partition(nums.begin(), nums.end(), [](int x) { return x != 0; }); }; CHECK_INPLACE(move_zeroes(v), v, "[1,3,12,0,0]"_vi); auto v2 = "[3,2,2,3]"_vi; auto remove_val = [](std::vector<int> &nums, int val) { return static_cast<int>(std::remove(nums.begin(), nums.end(), val) - nums.begin()); }; CHECK_FIRSTK(remove_val(v2, 3), v2, "[2,2]"_vi); /* --- dbg.h:冒烟(stderr 输出,不参与断言,编译运行即视为通过) --- */ auto nums = "[1,2]"_vi; DBG(nums, nums.size() + 1, std::make_pair(1, 2)); /* --- S2V/V2S --- */ CHECK(V2S(S2V("abc")), "abc"); // 故意失败的用例,默认不编译 #ifdef CHECK_FAIL_DEMO CHECK(1, 2); CHECK("fail with label", "[1,2]"_vi, "[1,3]"_vi); CHECK_ANYORDER(std::vector<int>{1, 1}, "[1,2]"_vi); #endif return 0; } |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 | PASS [1, 3, -1] PASS [[1, 2], [3], []] PASS [ab, c] PASS [1.50000, 2.00000] PASS [1, 0] PASS [] PASS [a, b, c] PASS [1 -> 2 -> 3] PASS 1 PASS [1, null, 2, 3] PASS 1 PASS [1, 2] PASS [(1, 2)] PASS (1, a) PASS null PASS 0.30000 PASS 1024.00000 PASS 2.00000 PASS labeled case 2 PASS [1, 2, 3] PASS anyorder labeled [1, 2] PASS [1, 3, 12, 0, 0] PASS k=2 [2, 2] [test_check.cpp:54] nums = [1, 2], nums.size() + 1 = 3, std::make_pair(1, 2) = (1, 2) PASS abc FAIL scripts/test_check.cpp:62 expected: 2 actual: 1 ^ FAIL fail with label scripts/test_check.cpp:63 expected: [1, 3] actual: [1, 2] ^ FAIL scripts/test_check.cpp:64 expected: [1, 2] actual: [1, 1] ^ == 24 passed, 3 failed == |
而最后一个就是 parse,提供了 UDL (User-defined Literals, 用户定义字面量)。之前的 VEC(1, 2) 虽然已经可以了,但是 LeetCode 那边提供的格式却是 [1, 2]。数组还好,可以直接复制中间的内容,但像是链表、二叉树,要怎么办呢?
为了让我可以直接复制提供的样例,就加入了 UDL,直接用对应的类型包裹,然后会自动进行解析。这也就是上面看到的 ""_vi 等了。
1 2 3 4 5 6 7 8 | "[1,3,-1]"_vi // vector<int> "[[1,2],[3]]"_vvi // vector<vector<int>> R"(["ab","c"])"_vs // vector<string> "[1.5,2.0]"_vd // vector<double> "[true,false]"_vb // vector<bool> "[1,null,2,3]"_tree // TreeNode*(BFS 序,null 为空位) "[1,2,3]"_list // ListNode*(空 "[]" 返回 nullptr) "abc"_vc // vector<char> |
此外还学到了 C++11 中加入的 raw string,即上面的 R"(...)"。
由此便提供了近乎完美的本地调试体验,夸张一点的说法就是,写题、调试甚至成为了「享受」。
工具层面
上面主要是调试之中的体验优化。还有一些其他琐碎的要点。
首先是 .clangd 的修改。
1 2 3 4 5 6 7 8 9 10 11 | If: PathMatch: .*\.h CompileFlags: Add: [-x, c++-header] --- If: PathMatch: solutions/.*\.cpp Diagnostics: UnusedIncludes: None CompileFlags: Add: [-Wno-unused-variable] |
为了兼容(虽然说其实只需要一个全局替换),还是沿用了 utils.h 等的 .h 的写法,但这就让 Clangd 服务器把它当成了 C 的头文件,会有一些不必要的警告。因此加入了规则,这是一个 C++ 项目,即便用了 .h 还是要当成 C++ 的头文件。
然后就是借题,去掉了一些干扰性质的警告,如没有直接使用的头文件、没用的变量等。不过后者其实在 compile_flags.txt 中也有写,唔,不知道能否让 Clangd 也获悉?
.clang-tidy 基本上是从之前继承过来,然后根据实际体验调整关闭了一些警告。
后面也调整了一下 .clang-format,明确设置为了 LLVM 格式,主要是额外根据实际情况加了规则。
还有一个,之前用的是 CMake,但我不会用,没怎么学过。加上其实我要的功能没那么复杂,就是编译某个题解文件、运行它,最多还有个调试而已。于是我就想用更为熟悉的 Just。便使用一些脚本并迁移到了 just 的工具链,最初提供了下面的一些方法(有改动):
1 2 3 4 5 6 7 8 | Available recipes: run F # 编译运行(LeetCode 题解不释放节点,关闭 LeakSanitizer 防误报) debug F # 无 sanitizer 编译供 gdb/DAP;stdout 最后一行为产物路径(nvim 键位读取) build-all # 全量编译(迁移验证 / utils.h 改动回归)。只编译不运行 test-utils # utils.h 回归测试 stats # 重生成 README 进度表 note F # 从模板创建 Typst 笔记(notes/<id>.<slug>.typ) commit # 半自动 jj 提交 |
例如可以用 just run 1 运行第一题,这也是后面在编辑器层面的「执行」中实际使用的命令。
1 2 3 4 | PASS [0, 1] PASS [0, 1] == 2 passed, 0 failed == |
而 just debug 则会生成对应的 .dbg 文件,用以给 gdb 进行调试。
just stats 则会根据进度更新 README 进度表。在练习尾声的时候,我将其作为了提交的依赖项,这样可以每次提交前都更新一下进度,不用手动更新。
而 just commit 就是提交了。我的提交不是简单的提交,而是有一定的规则。
像之前的格式就是 W7D1(4)[10.22]: 完成 T347, 144, 145, 94。因为我当时的练习模式就是一周练固定几天,于是就有了这样的方式:
W7代表这是第 7 周;D1代表这是当周规则上的第一天,或者也可以简单理解为该周第几次练习;(4)代表这一天做了 4 道题;[10.22]代表这一天实际代表的天是 10.22。不能用 commit 或 author 日期代替,因为我时常会忘记提交;- 隐含了年份 2025,也许也是因为认为我坚持不到一年,真是精准又犀利的判断呐……
- 不过认真说当时应该是深思熟虑过的,因为一年后推免都结束了大概,没必要额外注明年份。
- 然后是完成的题目,其中最开始以
T开头,顺序按照真正的完成顺序。
这个格式虽然在我这时候已经不适用了,但规则本身是必要的,因此进行了一些调整,改成了 2026-08-13(5): 完成 T28, 206, 24, 19, 142:
2026-08-13直接以日期开头;(5)依旧代表做了几题;- 后面完全一致。
2026.8.12
- 对了明天还要改一下默认的 description 模板,不打算用周模式了,直接用当天日期。尽量早上完成。
而这个信息,其实完全都可以自动生成的。在之前我就是手写,毕竟周数和天数都不太好解析,然后还有完成顺序的依赖。但是换成现在就很简单了,只需要获取天数,统计变化即可。
因为最开始我是在重做部分旧题,就使用 mtime 进行排序,后面开始做新题后就改成了 ctime。但其实我偶尔会翻提交,这个时间顺序有的不太准确。可能跟我编辑的顺序有关,但我也不太在意了。
笔记层面
当然,我还是忘不了我那笔记呀。摸了一个 Typst 的笔记模板,同时还加入了上面的 just note 命令支持。
直接看 showcase.typ 吧:
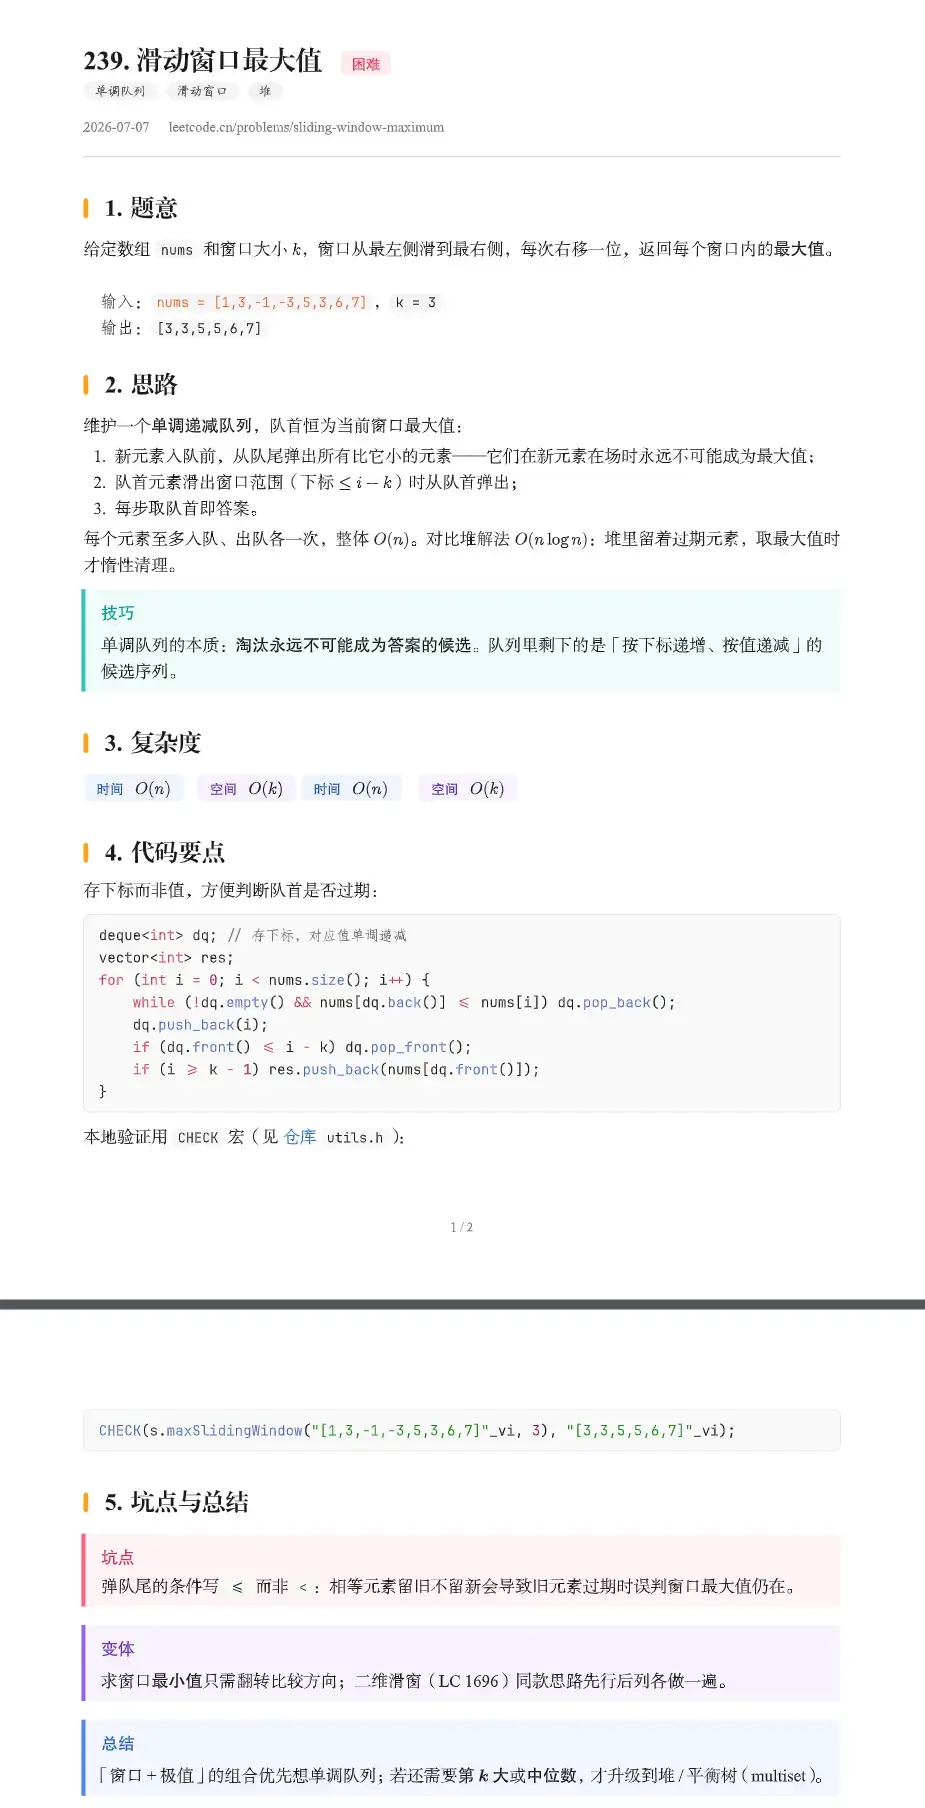
结果当然还是一次都没用过,又是成了摆设。
leetcode.nvim 准备
上面讲的都是题解仓库那块的准备,与之并行的便是 Neovim 编辑器一侧的准备了。
差不多是期末一周后,实现了基础的 Neovim LeetCode 支持,且我审核了一下代码并进行了简单的测试。
我期末那会提到的插件便是 kawre/leetcode.nvim: A Neovim plugin enabling you to solve LeetCode problems.,在上面这个提交中也是进行了一些基础工作。
选择的映射命名空间是 <leader>k,其中 k 可以认为是取 LeetCode 意(音)。
当然,比较牵强,实则是选了一个没有被占用的,因为 <leader>l 和 <leader>c 都已经有了占用。虽然说按照前面的原则,<leader>l/L 对应的 LazyVim 映射并不常用且占据了一整个命名空间,但考虑到现在映射也不是很紧张,加上这个 LeetCode 其实用处非常局限,就依旧保留了,作为以后更为常用且广泛的用处的选择之一。不用大写也是因为在用到的时候比较频繁。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | map("<leader>kk", "<cmd>Leet menu<cr>", "主面板") map("<leader>kc", "<cmd>Leet console<cr>", "测试用例控制台") map("<leader>ki", "<cmd>Leet info<cr>", "题目信息") map("<leader>kt", "<cmd>Leet tabs<cr>", "已开题目") map("<leader>ky", "<cmd>Leet yank<cr>", "复制提交区") map("<leader>kL", "<cmd>Leet lang<cr>", "切换语言") map("<leader>kr", "<cmd>Leet run<cr>", "远程样例测试") map("<leader>ks", "<cmd>Leet submit<cr>", "提交") map("<leader>kR", "<cmd>Leet random<cr>", "随机一题") map("<leader>kl", "<cmd>Leet list<cr>", "题单") map("<leader>kD", "<cmd>Leet daily<cr>", "每日一题") map("<leader>ko", "<cmd>Leet open<cr>", "浏览器打开") map("<leader>kS", "<cmd>Leet last_submit<cr>", "恢复上次提交代码") map("<leader>ke", "<cmd>Leet reset<cr>", "重置代码部分") map("<leader>kI", "<cmd>Leet inject<cr>", "重新注入") map("<leader>kd", "<cmd>Leet desc toggle<cr>", "题面开关") map("<leader>kC", function() ... end, "重新生成样例 CHECK") map("<leader>kb", function() ... end, "本地编译运行") map("<leader>kg", function() ... end, "编译并调试") map("<leader>kn", function() ... end, "笔记") |
上面就是我经过调整的、截止目前使用的全部相关映射了。除了「随机一题」和「每日一题」外,好像都或多或少有用过。function 就是调用相应的 just 命令或外部脚本。
还是从上面那个提交开始写起。根据我的配置,可以使用 nvim leetcode.nvim 来启动 LeetCode 刷题的专属会话。
模板实例如下(有改动):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | // @leet imports start // Created: 2025-09-10 17:49:33 #include "../utils.h" using namespace std; // @leet imports end // @leet start class Solution { public: vector<int> twoSum(vector<int> &nums, int target) { unordered_map<int, int> mp; for (int i = 0; i < nums.size(); i++) { auto it = mp.find(target - nums[i]); if (it != mp.end()) { return {it->second, i}; } mp[nums[i]] = i; } return {}; // __builtin_unreachable(); // GCC/Clang } }; // @leet end int main(void) { Solution s; CHECK(s.twoSum(""_vi, 3), "[0,1]"_vi); CHECK(s.twoSum("[2,2,1]"_vi, 4), "[0,1]"_vi); return 0; } |
可以看到其实还是分成了三个区域,只是 Import 区有了额外的标识符,且主 Code 区标识符也发生了变化。
旧题解的迁移发生在一次提交中,有意思的是,迁移后净代码量反而减小了。不过这应该是我删掉了原来的 .clang-format,用了 LLVM 格式的缘故。
虽然说可以直接 nvim leetcode.nvim 直接开启练习,但并不是所有工作都能在 Neovim 里面完成的。当然,终端方面的事情可以使用 Neovim 的内置终端,但这还不够,例如说你想保持着上一次运行的结果,但同时还要新的终端等。
此外,由于插件设置了 winfixbuf,缓冲区会被固定,无法直接通过正常的缓冲区操作切换缓冲区,自然也没法自由地看其他文件了。对于题目,可以用 <leader>kt 切换打开过的题目,也可以用 <leader>kl 打开题单进行搜索,但对于其他的,就需要其他的 Neovim 实例了。例如说我还需要开着机试的计划等等。
虽然开一个终端标签页可以一定程度上解决这个问题,但显然不够好,而且重启后也无法恢复。自然,我就想到了 Zellij。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | function leetcode() { local repo="..." if [[ -n "$ZELLIJ" ]]; then (cd "$repo" && nvim leetcode.nvim) return fi local line line=$(zellij list-sessions -n 2>/dev/null | grep '^leetcode ') if [[ -n "$line" ]]; then if [[ "$line" != *EXITED* ]]; then zellij attach leetcode return fi zellij delete-session leetcode >/dev/null 2>&1 fi zellij --session leetcode --new-session-with-layout leetcode } |
这便是我写在 ~/.zshrc 的配置了,定义了一个 leetcode 函数,然后它会检测当前是否有正在运行的 LeetCode 练习会话,有的话就会附着上去,否则的话会进行重置(直接恢复原貌)。
这里还定义了名为 leetcode 的布局,在最开始就是简单的两个标签页,其中一个运行 nvim leetcode.nvim,是练习的主力,另一个就放着题单。这样的话即便是关机了之类的,只要重新输入 leetcode,就能立刻恢复并进入 LeetCode 的练习状态。
上面加入了笔记功能,虽然最后是没有用到,但在当时我还是为其准备了一个 <leader>kn 的映射,用以在 Zellij 中打开一个 stacked pane:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | map("<leader>kn", function() local file = current_solution() if not file then return end local res = vim.system({ "just", "note", file }, { cwd = repo_root(), text = true }):wait() if res.code ~= 0 then vim.notify(res.stderr or "创建笔记失败", vim.log.levels.ERROR, { title = "leetcode" }) return end local note_path = vim.trim(res.stdout) local in_zellij = vim.env.ZELLIJ ~= nil if in_zellij then local cmd = { "zellij", "action", "new-pane", "--stacked", "--name", "note", "--", "nvim", note_path, } vim.fn.jobstart(cmd, { detach = true }) vim.notify("已在 Zellij 新 pane 打开笔记", vim.log.levels.INFO, { title = "leetcode" }) end end, "笔记") |
而在正式开始练习前,我进行的最后一项准备,大概就是调试了。
虽然我上面写打印就是最好的调试,但我在最初还是有想过用调试器的。可以说 Neovim 唯一体验上落下风、不如 VS Code, CLion 的就是调试了。这个确实不好用。
测试过程中,我注意到步入的时候有时候会不小心步入了「无关代码」,如标准库函数,还有就是我自定义的这些辅助调试的库函数。因此进行了一些自定义,排除了自动步入这些函数,只会在自己写的题解中漫步。
不过最后还是没怎么进行调试。一来效率太低了,重新启动然后执行到目标位置,都够加入 DBG 观察需要的变量执行好几次了。二来 TUI 中的调试确实很怪,UI 也很不舒服。反而是为了加入这样的支持弄了一些全局 hack 的东西,让我有点不舒服。
最后的准备工作在 7.9 差不多就完成了。
演进
然后可以跳过一个月,直接到 8.12 了。
没错啊没错,准备工作做完了以后就晾在那里了,差点又成为了花瓶。直到一个月以后才「不能再这样下去了」,重新捡了起来。
2026.8.12
- 难绷,好久没登录了,LeetCode Cookie 直接过期了。还得重新搞。
- 下午快两点终于开始做了。第一题重做二分查找,感觉做了快半个钟,乐。不过还算顺利最终。印象中写得比之前简明(之前 28 行,这次 25 行),可以看看标答。嗯,然后很快就要长休息了……看了看标答确实更好,我觉得手抄一下吧,长长记性。不知道要不要 Anki 记录一下。
- 算法练习做了九道题,很不错了。按我最初设想的一题一分,都可以拿到十分了(哦不太行,今天 RSS 没清完),当然因为是重做含金量没那么高就是了,虽然我也全忘记了。
- 还有就是实际练习过程中遇到一些问题,也顺手解决了,例如一些配置、工具库函数等。
- 下午倒是认认真真开始练习算法,差不多做了四个小时吧,当时应该是做了「数组和双指针」的五道题,还有「字符串」第一题很简单。
- 晚上回来摆了一会,然后去看纪录片,后面做了「字符串」剩下三题,最后一题依旧用了暴力,去看视频学了一下 KMP,感觉我已经会了,明天先自己写一下。
写本文重新打开的时候,Cookie 也过期了。
格式化
最开始重设 .clang-format 时,除了设置样式基准为 LLVM 外,还有一个就是弄了 AllowShortFunctionsOnASingleLine: None,也就是不允许函数单行。
这是因为创建一个新题后,它的函数体本来就是空的嘛,如果习惯性地在开始的时候保存了一下,那就会自动格式化为 {} 了,还得进去后回车,有点不便。
而 8.14 的时候修改了这一个行为,允许空函数单行。这是为什么呢?因为那会写到一种新题型了,并非提供 Solution 类,而是给了一个要实现了类,而构造函数是空的,这样格式化后 {, } 不在同一行,有点丑陋。
那岂不是又恢复了默认行为?其实不是的,只是将 None 改为了 Empty。之前很大一部分不便不仅仅来源于空函数变成了单行,还来源于单行函数也变成了单行,在你写了一行变量初始化的时候顺手保存一下,都会变成一行,这其实才是更为不爽的一点。相较而言,可以容忍空函数成为单行。
自动导入头文件
写着写着,又遇到一个问题。Clangd 会自动帮我在 #include "../utils.h 后加入对应函数的头文件。这其实是不必要的,因为我在 utils.h 中已经加入了万能头了。
而经过我的调查,这个是写在了 LazyVim 的配置当中,命令行参数加入了 --header-insertion=iwyu,因此即便配置 .clangd 也没有效果。
还有一种解决方法就是在设置里面覆盖掉默认,但我觉得也太不优雅点了,何况我只想对这个工作目录生效而已。
2026.8.14
- 神了,做最后一题想要关闭自动 import,我明明全都引入了默认,结果关不掉,因为 LazyVim 默认设置好了,除非我覆盖。唉唉,没辙了,感觉关掉全部引入得了。
当然在调查过程中我还认识到一个选项 exrc,可以创建 .nvim.lua 作为项目级别的 Neovim 配置,
不过权衡之下我还是没有选择,因为这样其实有安全隐患。上面调试方面的配置其实也是因为这样,才不得不选择在全局的配置中进行丑陋的 hack。而这里,我认为算是小问题,就放弃了。
最终就是保留了这个行为,自动引入就自动引入吧,也当让我认识认识了。
Anki 与新笔记
「贼心」不死,在上面的时候我提到过,刚开始写了没多久,我就认为还是有必要记忆一下解法的。因此又动了 Anki 的心思。
2026.8.12
- 此外最后一个小时还开了 Claude 做 Anki 卡片的计划,大致商量完了,让它自己实现了,希望明早起来看不会消耗太多额度吧。
最初的想法就是这样,问题和代码都是由脚本自动生成,而其他字段,如提示、思路、笔记、相关知识等,就待我复习的时候,手动进行补充。不必长篇大论,随手记即可,因为我写题、看解答的时候确实会有一些想要记下来的冲动,目标就是把这个冲动落到实处。
不过这次倒是没有成为摆设,而是很快就投入了使用。我自动导入卡片,然后在预览的时候一张一张过,有的有了点念头后就即可记录下来。
2026.8.14
- 晚上回来立刻就开始做了,是这几天晚上最早恢复的了,因为去吃饭的时候就在想了。不过可惜的是好像还是没做出来,后面看了思路后自己写了一遍,过了,然后再学标答改。然后最后一点时间导入 Anki 并加笔记,不过没啥时间了。
当然,也会遇到一些问题,然后深入探究一番。
2026.8.15
- 下午折腾好久 Anki。
- 加入了代码的白天模式支持,现在更适配主题一些了。
- 反倒是字体花了好久时间,太特么恶心了。一直用
JetBrainsMono NF,结果不行,各种折腾,试过了JetBrainsMono NFM、JetBrains Mono等都不行。后面终于试了一下JetBrainsMono Nerd Font才行。这个字体名字问题真的太恶心了。尤其是 Flash 还给我过个脚本检测是可以的。 - 然后刚刚我忘记了 NFM 有啥用,去删掉了。刚删完才想到 gVim 要用,果然如此,灰溜溜装回来。折腾到现在四点出头,我还没搞完笔记呢。
有意思的是,后面配 Neovide 的时候字体名称也是 JetBrainsMono Nerd Font。NF 也是受到了 gVim 的影响,它就是这样配的。
而很快我又对这个模式不满意了。这个模式是一天练完后再将想法记录下来,但其实这时候很多早已烟消云散了。
此外很不方便的一点是,因为有的题有多解,而且我觉得都有记录的价值,而默认就是只有一种解法会同步进去,因此在一开始我就是手动将第二个解法复制过去,然后进行批注。但带来的一个问题就是破坏了单一知识来源,额外解的代码有时候看的时候又觉得不够完美了,这时候又得同时改代码和卡片两处,让我很是不爽。
因此我决定全面贯彻落实「单一知识来源」的思想,将笔记也全部集中在代码中,Anki 卡片直接从代码生成,不必后面自行添加内容。如有需要更新,更新代码即可,然后同步过去。
2026.8.16
- 下午开始搞 Anki,我打算继续优化一下,看看能不能直接在原文件里面写好了,直接推送到 Anki 不用改,这样也符合单一知识来源。
最后实现的模板如下。一共有下面的字段:
- 问题:LeetCode 题面,剥去了部分内容(如样例)避免太过冗长;
- 解答:代码与相应的思路、笔记;
- 提示:有时会提示额外思考一些题目无关、做题过程中学到的内容;
- 笔记:额外的笔记信息;
- 相关知识:顾名思义,没用过;
- 解数:解的数目,用以提示要思考几种解法;
- 随记:唯一一个不会同步的字段,用以实现「仅 Anki 端」的内容补充,不过也没用过。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | // @leet start class Solution { … }; // 主解法(提交远程的那份,照旧剥壳) // @leet end // @card hint // 正面可见的提示(Markdown,连续 // 行,空行写成单独的 //)。 // @card idea 迭代 BFS // 主解法的名字 + 思路(≈ 旧「思路」字段,渲染为「解法 1 · 迭代 BFS」)。 // @alt 递归 DFS // 该解法的说明文字(紧跟标记行的连续 // 行)。 class SolutionDFS { // 一律 class 形态,辅助函数写在 class 内 public: … // 可在 main 里 CHECK,与主解法同等测试 }; // @alt end // @card note // 全题级笔记(语言技巧、易错点等)。 // @card ref // 相关知识(导引其他题目/知识卡)。 |
给一个实际例子就是:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | // @leet start class Solution { public: vector<vector<int>> combinationSum3(int k, int n) { ... } }; // @leet end // @card hint // 如何快速枚举所有组合? // @alt Gosper's Hack // …… class SolutionGosper { public: vector<vector<int>> combinationSum3(int k, int n) { ... } }; // @alt end // @card note // …… |
显示效果如下(补全了没用过的两个字段用于完整的显示效果,同时背面缩小了比例为了显示更完整):
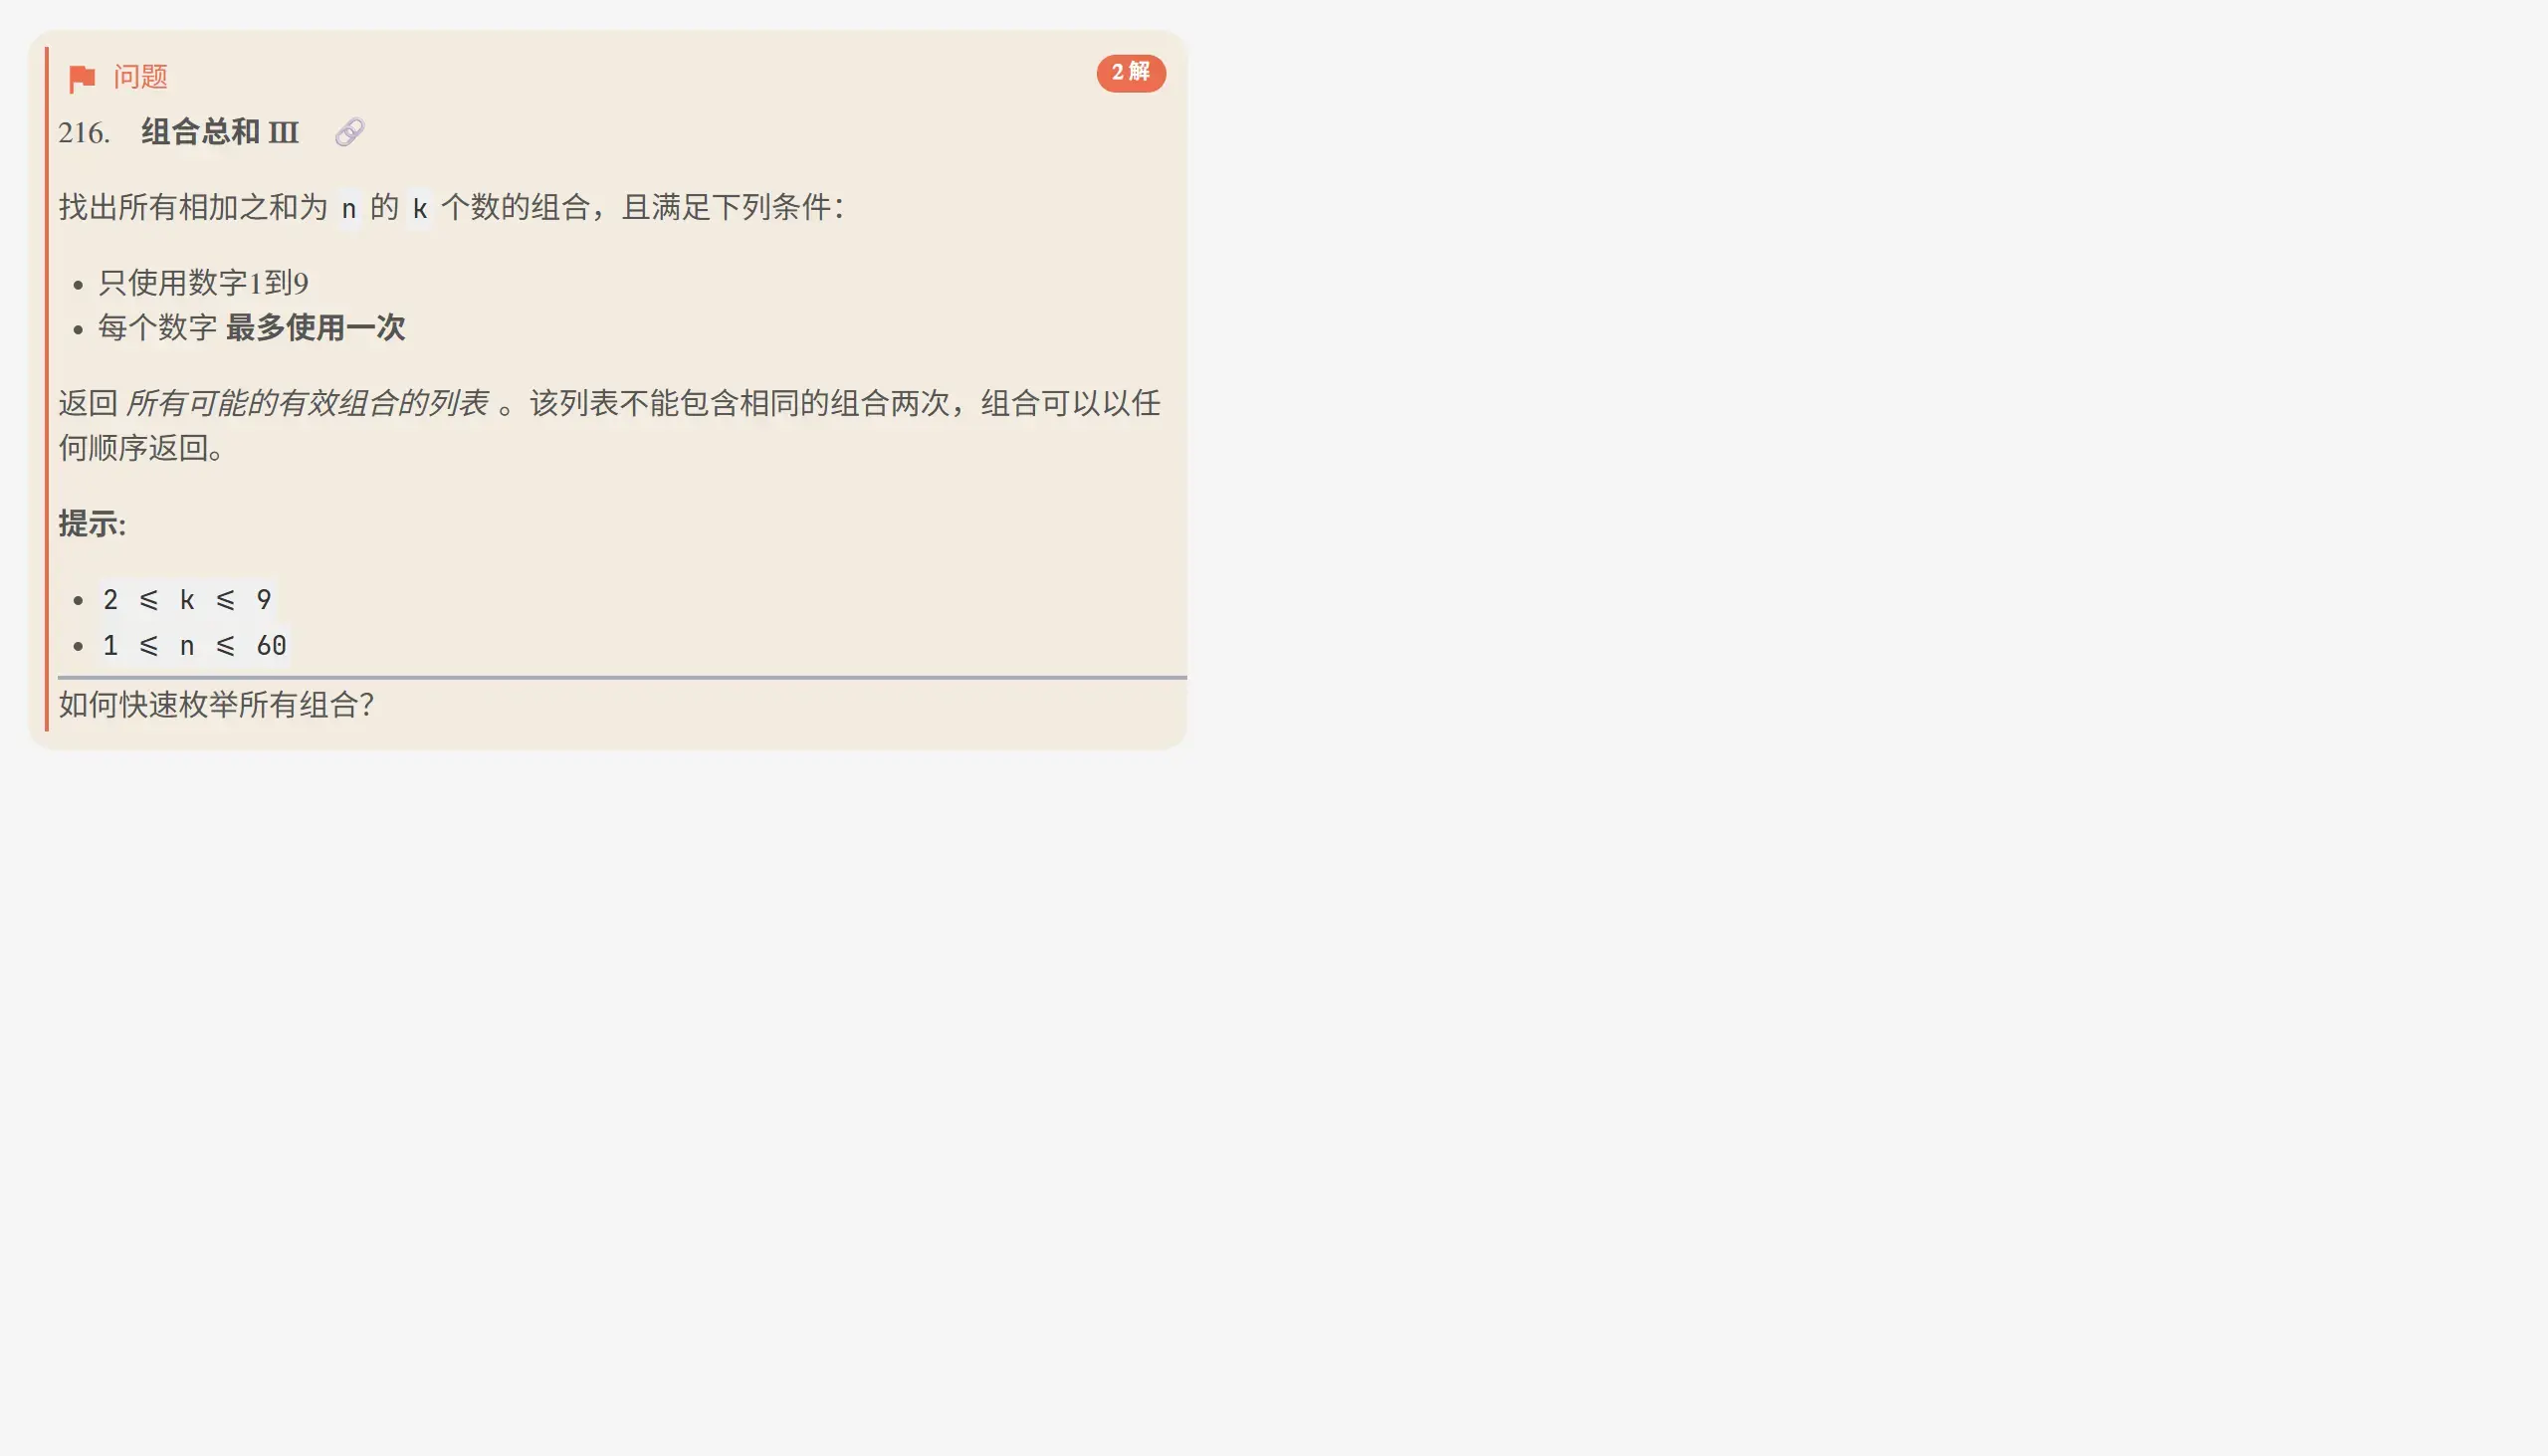
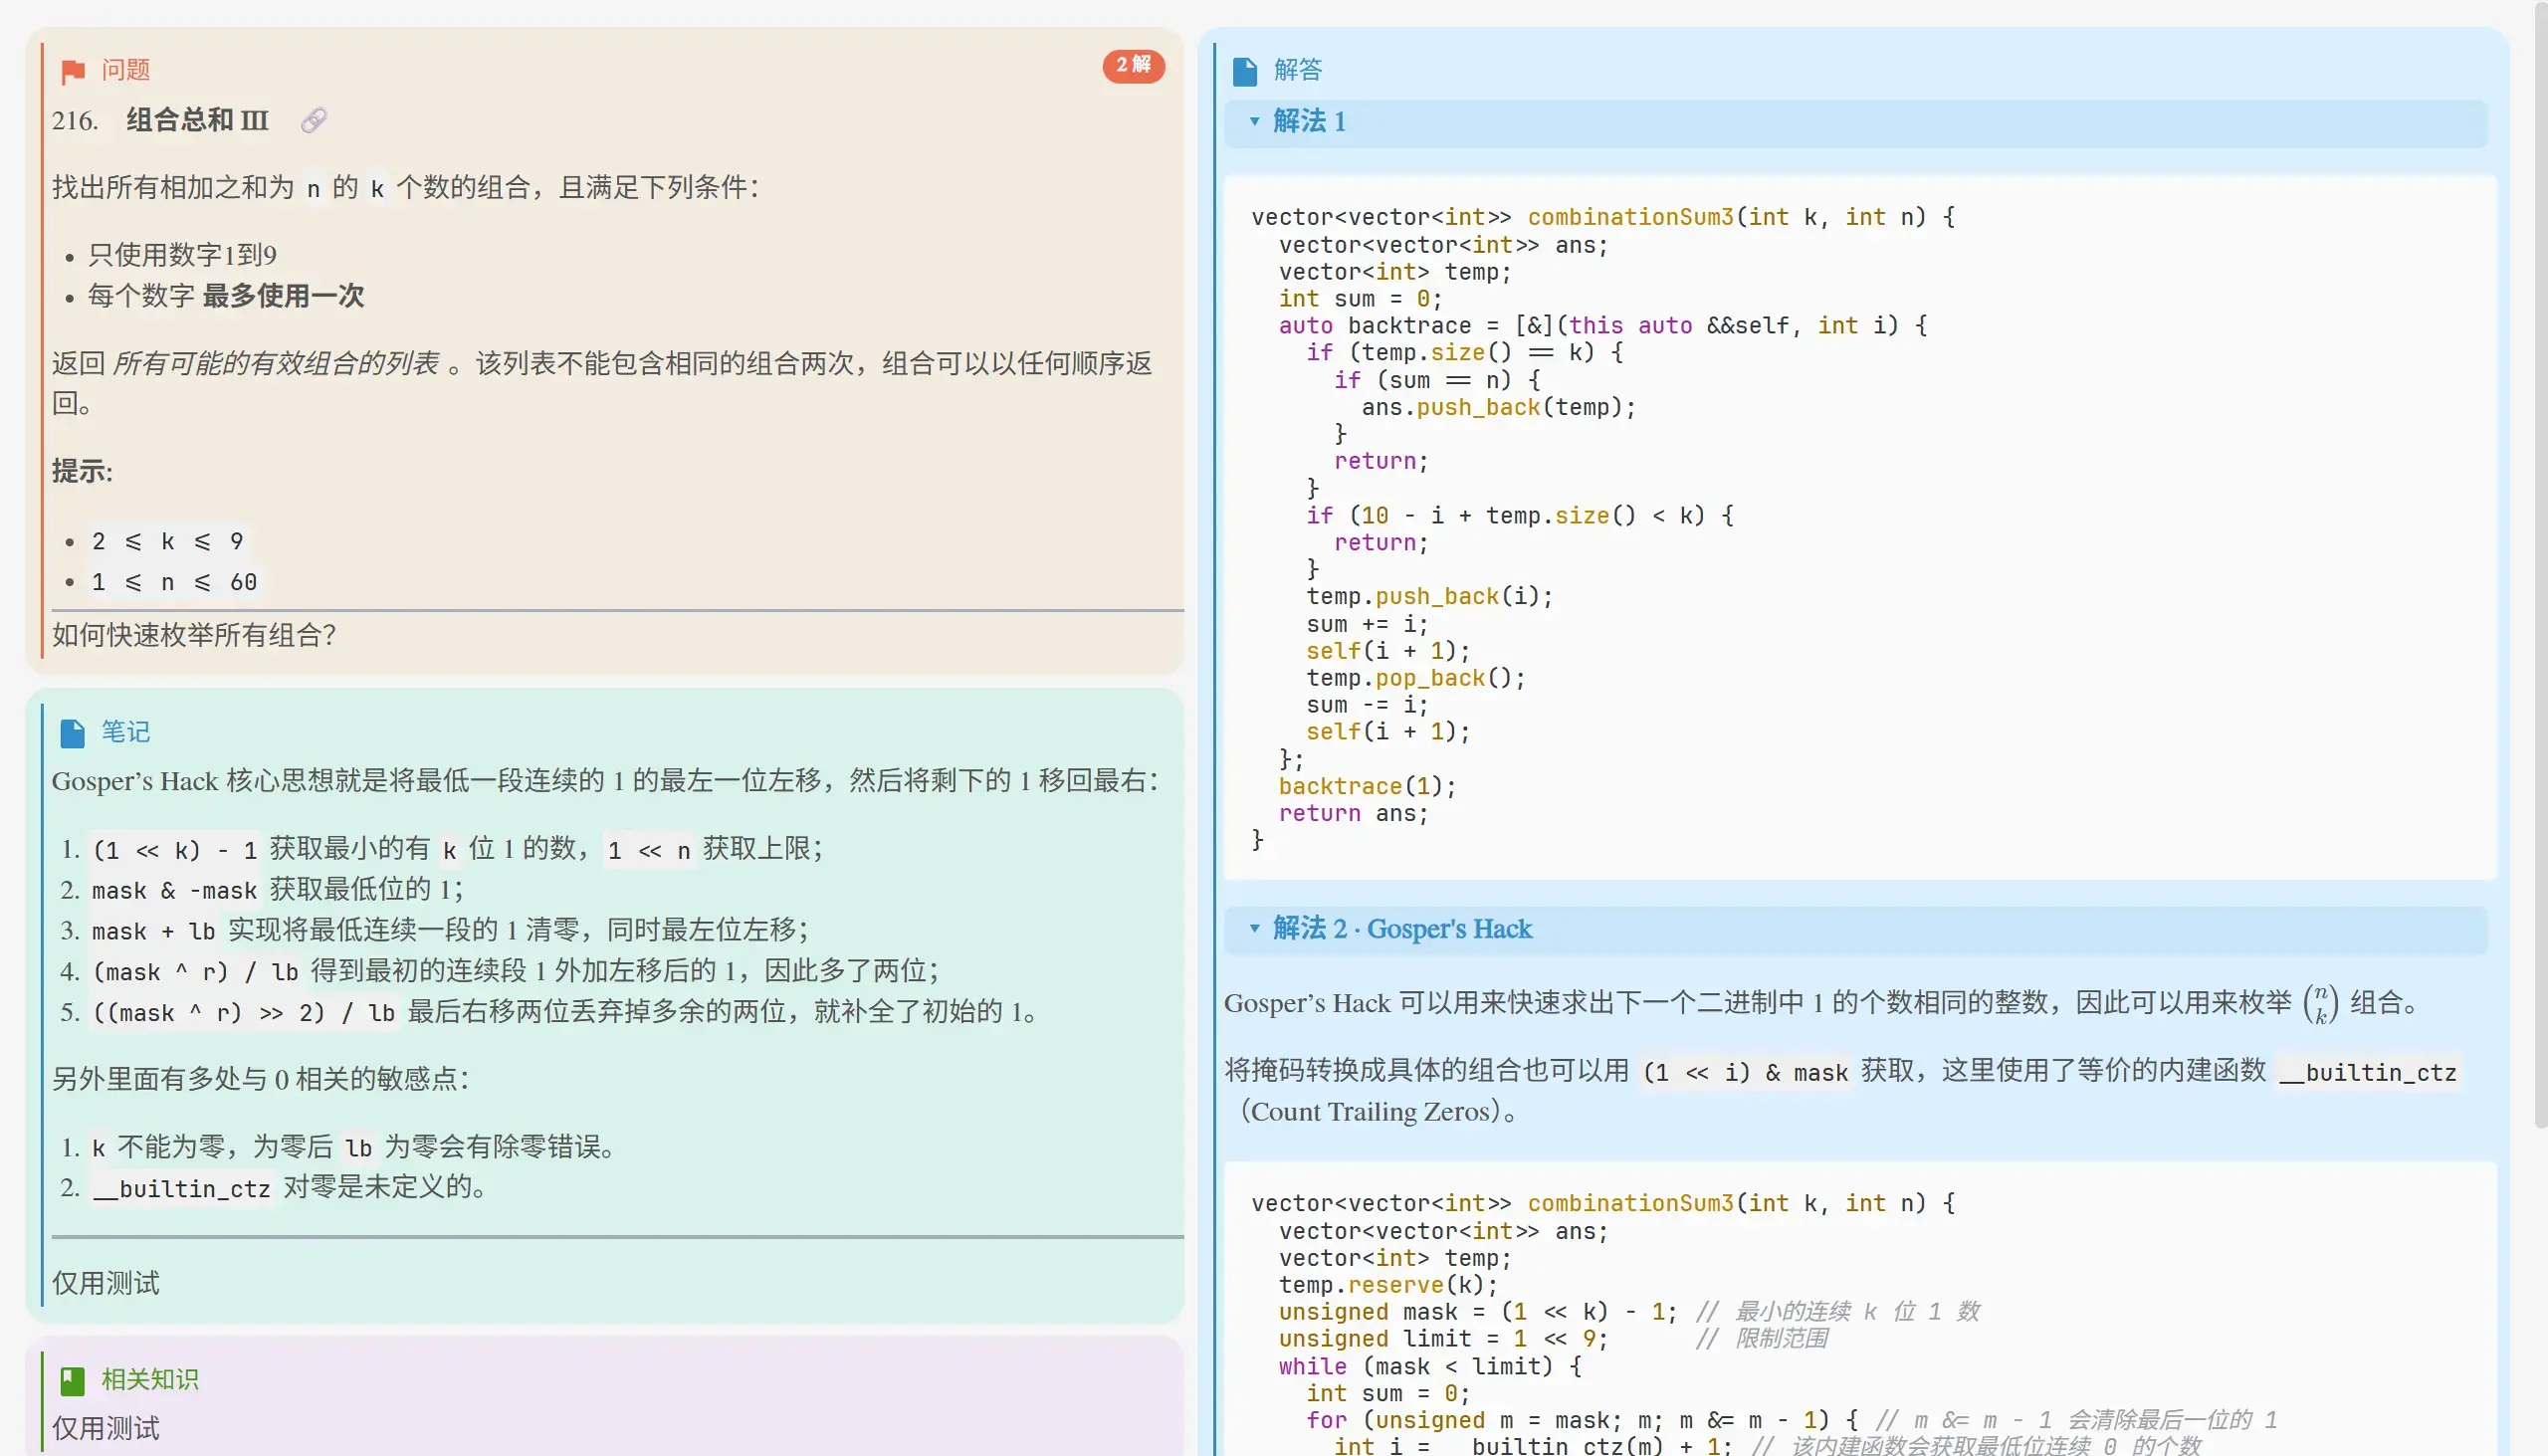
右边的多解也是可以折叠的。
然后这个笔记字段还特别有小巧思,它不固定在左栏或右栏,优先选择右栏,但如果加入它会溢出而出现滚动条,它就会跑到更矮的一栏。因此上图中它在左栏。
同时加入了 snippets,方便使用:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | local snippets = { s("cd", { t("// @card "), c(1, { t("hint"), sn(nil, { t("idea "), i(1, "解法名") }), t("note"), t("ref"), }), t({ "", "// " }), i(0), }), s("alt", { t("// @alt "), i(1, "解法名"), t({ "", "// " }), i(2, "说明"), t({ "", "class Solution" }), i(3, "Name"), t({ " {", "public:", " " }), i(0), t({ "", "};", "// @alt end" }), }), s("nodbg", t("#define DBG(...) ((void)0)")), } |
后面还加入了一个代码折叠的功能。有的时候会有很多冗余的写法,这些对于代码不可或缺,但是对复习的时候意义就不大了,因为模式重复。因此后面还添加了 // @fold 的支持,可以在卡片中折叠某部分代码,如:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | class Solution { public: vector<int> findMode(TreeNode *root) { vector<int> ans; int maxCount = 0; int count = 0; TreeNode *last = nullptr; // @fold auto visit = [&](TreeNode *node) { if (last && node->val == last->val) { count++; } else { count = 1; } last = node; if (count > maxCount) { maxCount = count; ans = {node->val}; } else if (count == maxCount) { ans.push_back(node->val); } }; // @fold end auto inorder = [&](auto &&self, TreeNode *node) { if (!node) { return; } self(self, node->left); visit(node); self(self, node->right); }; inorder(inorder, root); return ans; } } |
显示效果如下:
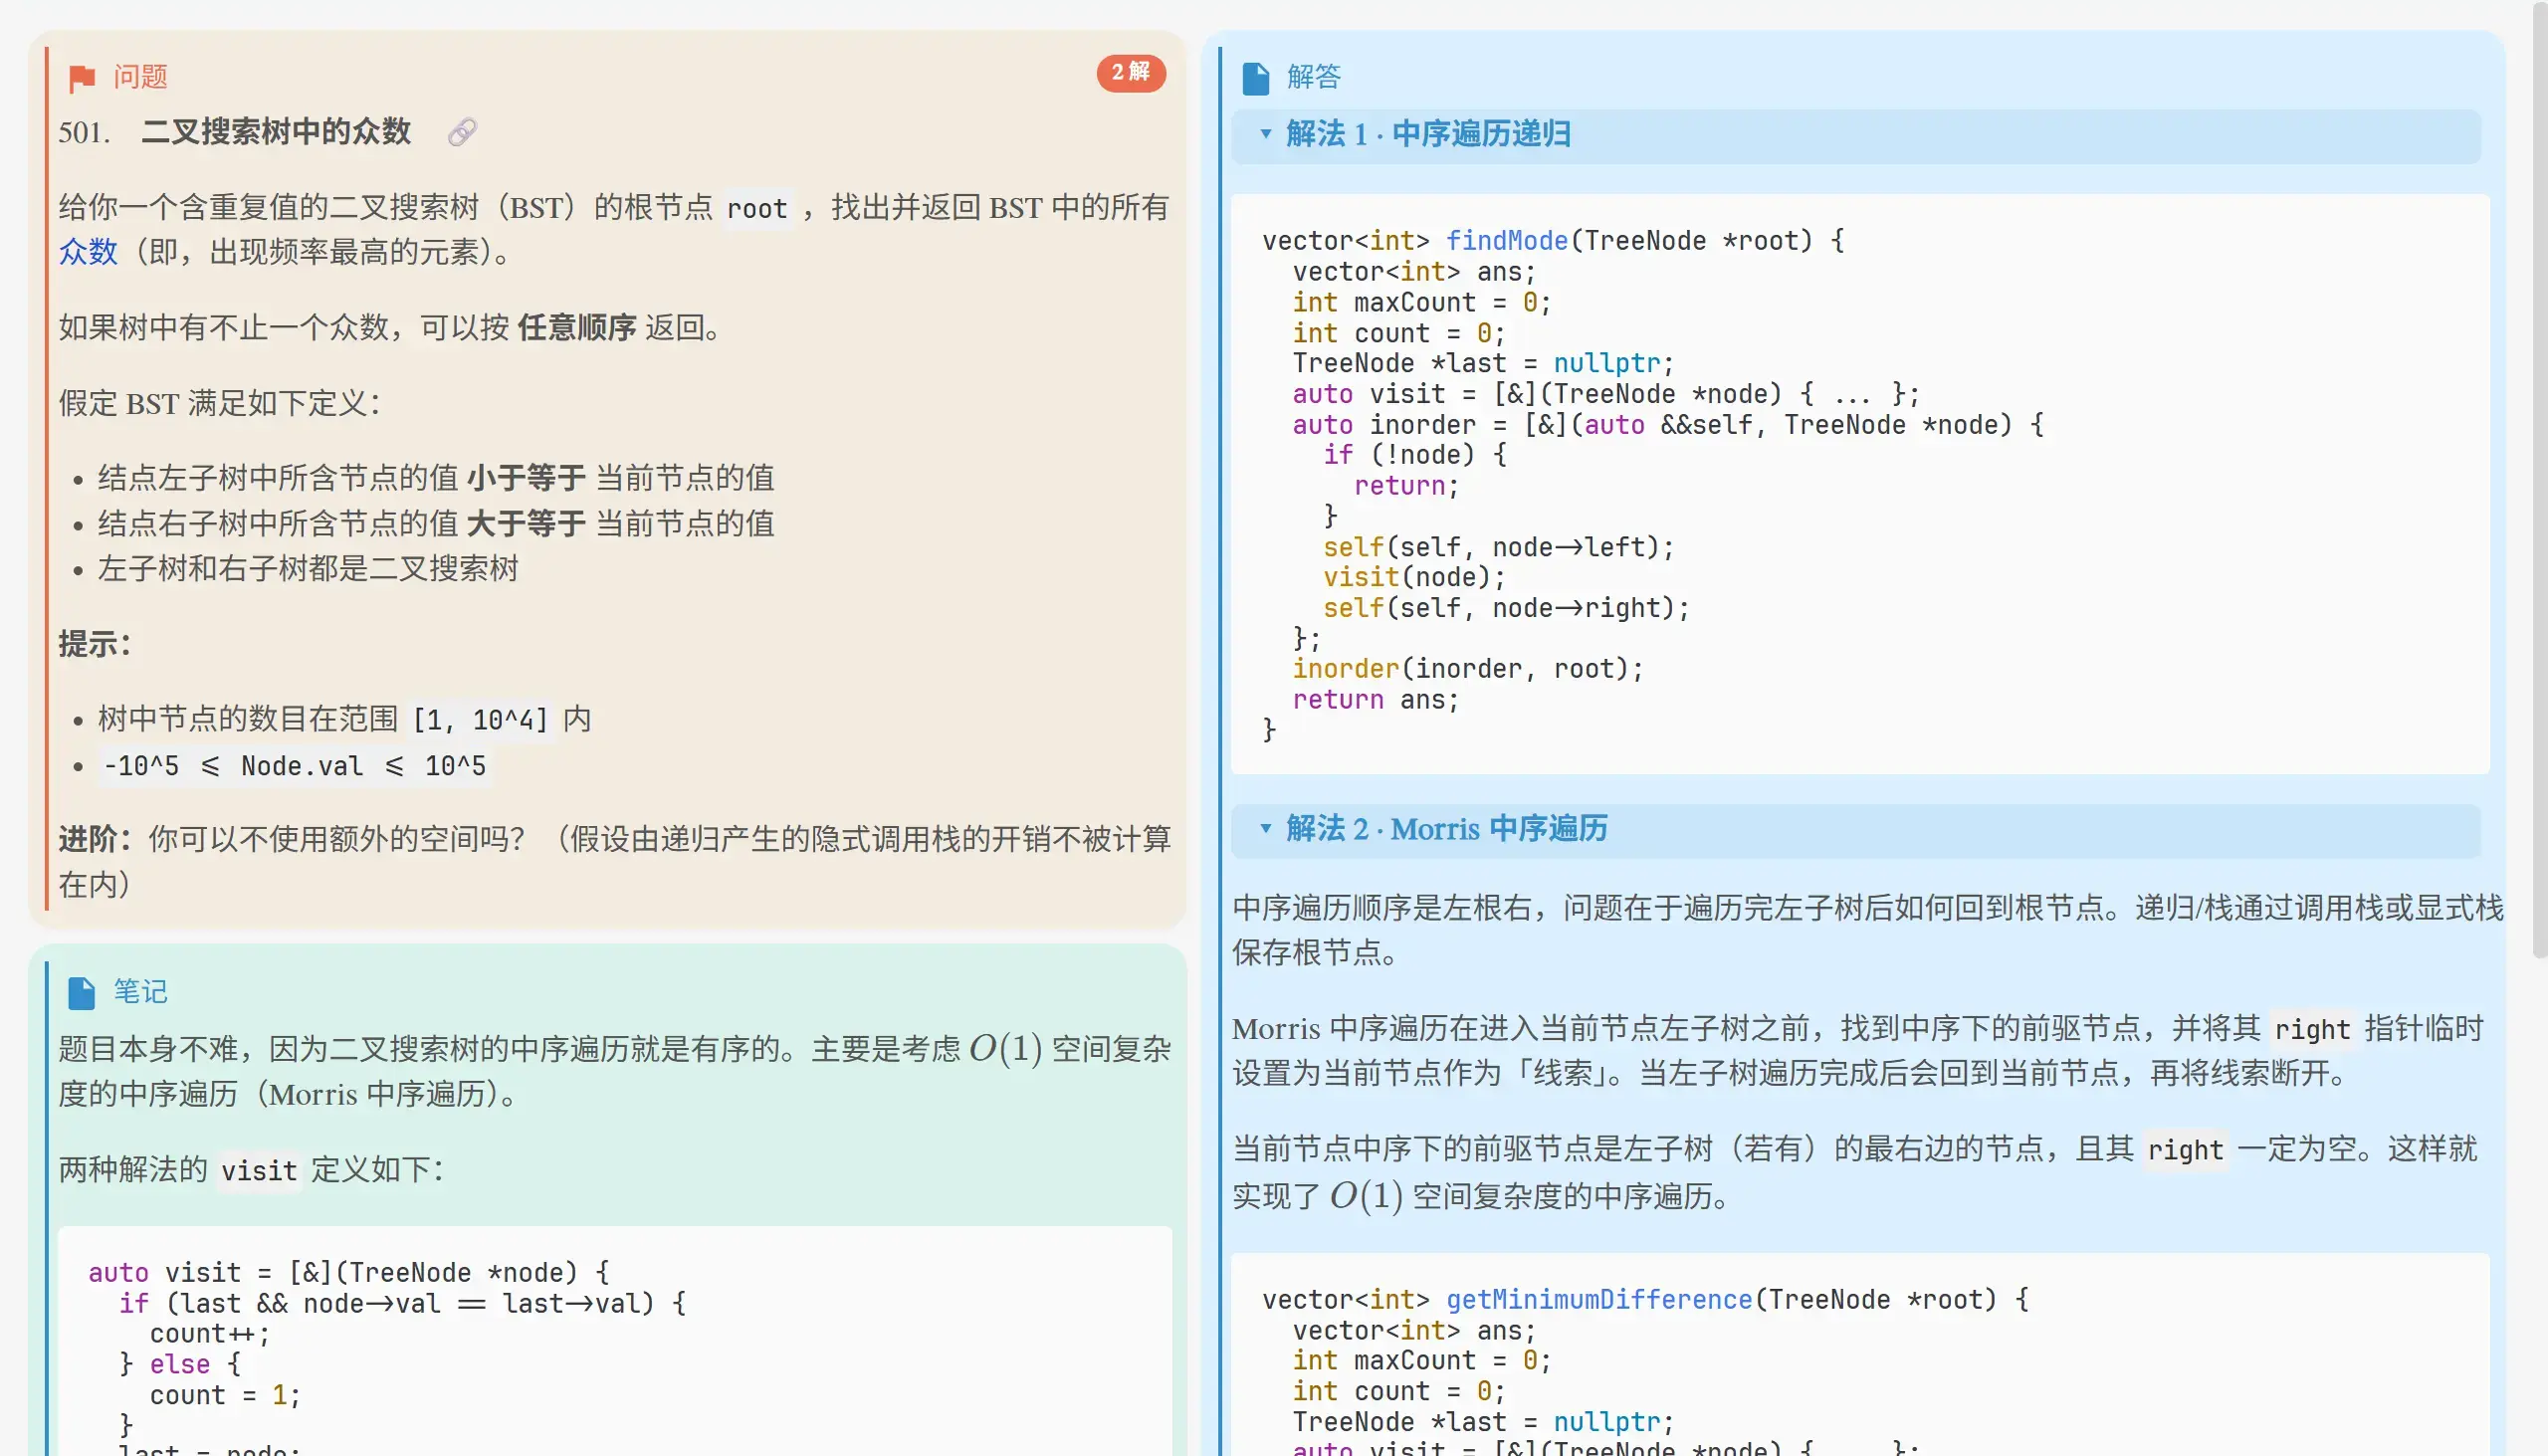
可见 visit lambda 的内容被折叠成了 ...,因为两个解法都有用到,但又不是重点,我将其抽到了「笔记」字段当中。
折叠也可以有相应的摘要代替默认行为[2],不过我没用过。
对于已有笔记的迁移,则是在这个提交中完成的。好在那时候还不算多,迁移没那么困难。
以及由于字段可能比较长,超过了限制,会被自动折叠,于是也调整了 .clang-format 的设置。
C++ 版本
最开始用的是 C++17,但确实很希望用上一些新语法,可以减少一些样板代码。
C++20 Ranges(以及后面版本的补充)自不必说,我还特地学了一下。不过其实我也没用几次,因为怕机试没有也不敢多用。下面是其中一个使用的例子,其实格式化效果挺差的:
1 2 3 4 5 6 | auto valid = [&](int k) -> bool { return ranges::fold_left(piles | views::transform([&](auto a) { return (a + k - 1) / k; }), 0L, plus<>()) <= h; }; |
不过还有一些小偷懒还是常做的,比如说 C++20 加入了基于范围的 for 循环初始化语句:
1 2 3 4 | for (int prefixSum = 0; auto n : nums) { prefixSum += n; ... } |
还有 bit_width 函数:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | int fib(int n) { if (n == 0) { return 0; } auto p = 0, q = 1; // F(0), F(1) // 或 sizeof(n) * 8 - 1 - __builtin_clz(n) auto bit = 1 << (bit_width((unsigned)n) - 1); while (bit) { auto r = p * ((q << 1) - p); auto s = p * p + q * q; if (n & bit) { p = s, q = r + s; } else { p = r, q = s; } bit >>= 1; } return p; } |
然后这一轮刷题,我不太喜欢脱离目标函数出去写工具函数。因为这样写得不流畅,你要先离开当前函数体,然后写完了再回来写调用,我感觉不够线性。因此我就大量地使用了 lambda 函数。
而 lambda 函数要写递归,你就得将 self 作为一个参数手动传入,非常难受:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | Node *connect(Node *root) { auto build = [&](auto &&self, Node *node, Node *parent) -> void { if (!node) { return; } if (parent && parent->left == node) { node->next = parent->right; } else if (parent && parent->next) { node->next = parent->next->left; } self(self, node->left, node); self(self, node->right, node); }; build(build, root, nullptr); return root; } |
当然,其实可以用函数容器 std::function,就可以不写 this 了:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | vector<vector<int>> findSubsequences(vector<int> &nums) { int size = nums.size(); vector<vector<int>> ans; vector<int> temp; function<void(int)> dfs = [&](int idx) { if (idx == size) { if (temp.size() > 1) { ans.push_back(temp); } return; } if (temp.empty() || nums[idx] >= temp.back()) { temp.push_back(nums[idx]); dfs(idx + 1); temp.pop_back(); } if (temp.empty() || nums[idx] != temp.back()) { dfs(idx + 1); } }; dfs(0); return ans; } |
但是其会进行类型擦除,性能上不如 lambda。
而 C++23 添加了 deducing this 特性,可以这样写:
1 2 3 4 5 6 7 8 9 10 11 12 13 | TreeNode *sortedArrayToBST(vector<int> &nums) { auto build = [&](this auto &&self, pair<int, int> lr) -> TreeNode * { if (lr.first == lr.second) { return nullptr; } int mid = (lr.first + lr.second) / 2; auto node = new TreeNode(nums[mid]); node->left = self({lr.first, mid}); node->right = self({mid + 1, lr.second}); return node; }; return build({0, nums.size()}); } |
无需在里面 self(self, ...),在外面也无需 dfs(dfs, ...) 了,这应该是我最常用的高版本特性了。
最终两次跳跃,升到了 C++23。
2026.8.17
- 今天算法练习改成 C++23 了,我太喜欢用 lambda 写递归了,懒得在外面写,结果这样就要
self(self, ...)。写多了也写烦了,就用 C++23 的 this 推导了。不过是先升到 C++20 用std::bit_witdh,当然是一解,后面优化的解法没用。然后再换成 C++23。但还是不能用太多比较新的语法,例如说 range 等,万一写熟悉了后面实际机试没那么新版本就完球了。只是这里 lambda 我写多了倒也无所谓了。
自动生成样例
我写着写着又又又烦了,虽然说已经有了 UDL,但样例还让我自己复制也太麻烦了吧。既然都给了,能自动生成吗?于是就去做了。
模板中的 // TESTAUTOGEN 会被自动替换为解析出来的样例,这下不用手抄了,爽。
虽然有的时候解析会有异常,例如说样例的格式过于复杂等——最初实现的时候没考虑太复杂的,也没有太复杂的实例——或者说不知为何样例数目解析有点问题,但总的来说还是裨益多多。
不过我后期的时候其实也挺少本地测试了,因为我发现 LeetCode 可以远程测试。我之前一直不怎么喜欢远程测试的,因为如果要调试的话也不方便。但是 LeetCode 的远程测试居然可以自定义用例,甚至不用给结果,会自动帮你判。
因此后面的时候,除非真的出现问题,否则都是优先走 fast-path,也就是直接远程测试先,过了就万岁交了。
自动移除 DBG
DBG 非常好用,但是我时常会遇到这样的情况,调试完改好了,兴奋地再交一发感觉这次一定过了,结果忘记注释或删掉调试语句,然后就是 LeetCode 远程不认识 DBG,编译就报错了,白白多了一次失败。
像一般机试的方式,那就是在本地定义一个 LOCAL 宏,然后在没定义的时候将其变成一个空语句。但我这里的 LeetCode 练习却不行,因为将 DBG 定义为空,一定得出现在 Code 区域中,否则 LeetCode 压根不知道。而这很难被我所控制,每次都写不仅不优雅,而且也不方便。
前面写到 snippets 时里面有一个从未使用过的 snippet nodbg,可以直接将 DBG 定义为 ((void)0),算是正解之前尝试的无奈之举。
我最初的想法其实是提交前有一个 Hook 检查是否出现了 DBG,有的话就终止提交并报错,提醒我自己删掉。不过这样一来,如果交了还是错的,那我还得重新加回来(虽然可以撤销)。
跟 Agent 交流过程中实现了一个更好的方式,那就是不只是检测,还同时将提交内容中的 DBG 替换成 (void)0,而本地保持不变,这样本地不需要任何修改。
最开始的思路是普通的字符串匹配,不过终究还是不够优雅。后面使用了 Tree-sitter,实现语义级别的匹配。妈妈再也不用担心我把调试语句一起上传上去了。
同时这个替换考虑得还挺周全,如果跨越了多行,还会补相应的空行,这样一来行号信息也是正确的。嵌套什么的就更不必说了。
Zellij 演进
Zellij 的配置方面也是在不断演进的。
有了 Anki 后,我就需要三个 tabs 了,分别就是代码、其他资料(如机试题单计划)、Anki。
这些基本上就是固定的,写在了布局当中:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 | layout { cwd ".../LeetCode" new_tab_template { pane pane size=1 borderless=true { plugin location="zellij:compact-bar" { tooltip "C-F1" } } } tab name="leetcode" focus=true hide_floating_panes=true { pane stacked=true { pane command="nvim" cwd="solutions" expanded=true { args "leetcode.nvim" } pane name="shell" } floating_panes { pane command="btm" } pane size=1 borderless=true { plugin location="zellij:compact-bar" { tooltip "C-F1" } } } tab name="..." cwd="..." hide_floating_panes=true { pane command="nvim" { args "..." // 机试计划 } floating_panes { pane cwd="..." command="..." { args ... // 其他命令 } } pane size=1 borderless=true { plugin location="zellij:compact-bar" { tooltip "C-F1" } } } tab name="anki" cwd="anki" { pane pane size=1 borderless=true { plugin location="zellij:compact-bar" { tooltip "C-F1" } } } } |
第一个 tab 里面还有一个隐藏的浮动窗口,执行的是 btm。因为有时候不小心无限循环了[3],这时候在 Neovim 的终端里面没法直接 Ctrl + C 结束进程(我可能要去调查一下如何解决?),这时候我就得去 bottom 手动杀掉进程了。
因此就在布局中也直接提前打开了,有备无患。唯一比较可惜的是,没法在布局中发送按键,因为 bottom 打开也不是直接就能杀进程的,得先按一个 e 展开进程列表。
不过看上面写着,好像有很多重复的部分,例如说那个 zellij:compact-bar 是一个每个面板都需要的状态栏,重复了好几次。其实理想的写法是下面这样:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | layout { cwd ".../LeetCode" default_tab_template hide_floating_panes=true { children pane size=1 borderless=true { plugin location="zellij:compact-bar" { tooltip "C-F1" } } } tab name="leetcode" focus=true { pane stacked=true { pane command="nvim" cwd="solutions" expanded=true { args "leetcode.nvim" } pane name="shell" } floating_panes { pane command="btm" } } tab name="..." cwd="..." { pane command="nvim" { args "..." // 机试计划 } floating_panes { pane cwd="..." command="..." { args ... // 其他命令 } } } tab name="anki" cwd="anki" { pane } } |
然而很遗憾的是,行不通,有 bug。
2026.8.21
- 有点变态,昨天 Zellij 发新版了,于是更新后给 Windows 也装了,打算同步调整一下设置,WSL 的老设置要加新功能、Windows 的设置要按需调整,调整过程中转移去调 LeetCode 的布局模板了。
- 结果其他都挺完美了,就遇到一个问题,浮动窗口无法隐藏。还以为是我写错了,没想到是一个长久的 bug 了:Set hide_floating_panes in parse_tab_node_with_template by zhyuri · Pull Request #3846 · zellij-org/zellij,两年了还没有合并么……
- 最后只能不用模板,自己复制一下了 compact-bar 插件了,然后给
new_tab_template弄。然而不仅如此cwd似乎也有点问题,调查一下,真麻烦啊。 - 唉正常使用确实很香,但一旦深入 bug 也是真的多,***。调查了一下应该还是 bug,
cwd对浮动窗口无效:[Layout] cwd composition is not working for floating panes · Issue #2660 · zellij-org/zellij。 - 大概就是同时有总
cwd与 tab 的cwd时,浮动窗口的相对路径会被全局的覆盖,而普通的则不会。解决方法就是浮动窗口不用相对的,也写绝对的得了。我看看工作量如何,弄一个 PR,但感觉也不会合。
第二个问题我修复了,不过意外的是很快合并了。看来作者比较忙,要是第一时间没看到的话就基本很难合了,因为我几个月前也有一个改动极小的 PR。
杂项
还有一些杂项,一并讲了。
上面将卡片信息一并整合在代码中,结果就有了警告,多行注释推荐用 /* ... */。呃呃了,关掉。
这段时间我也不是完全投入在算法练习中,也有时候会折腾一些别的。例如说学习了解了一下 fzf,然后发现 fzf 相关命令是可以配置的。
例如说我现在配置如下:
1 2 | export FZF_DEFAULT_COMMAND='fd --type f --hidden --follow --exclude .git' export FZF_CTRL_T_COMMAND=$FZF_DEFAULT_COMMAND |
大概就是默认用 fd 搜索文件,且包含隐藏文件等。然后 Shell 中可以用 Ctrl + T 模糊搜索目标文件,不用手打或一个一个 Tab。
不过在 LeetCode 这里我改了一下,改成了 fd --follow,排掉了隐藏文件。
这其实稍微有点不便,不过当时的思路大概是这样的:学到了 Ctrl + T,但是里面有好多如 .git 里面的文件,不好。再学到了 FZF_CTRL_T_COMMAND,然后了解到可以用 mise 控制项目级别的环境变量,遂设置了。最后感觉这个也值得全局设置,于是再给 ~/.zshrc(现 ~/.zshenv)添加了。
mise 其实也早有耳闻,但一直没什么机会用一下,因此这次也算是尝试了一下。
结语
其实 Neovim 时期的机试练习也就是从 8.12 开始,到 9.8 结束,不到一个月。而其中真正练习了的天数,其实也就 18 天。
但是在这 18 天中,我做了 151 张卡(也就是做了 151 题),并学习了其中 135 张[4],快速补全了机试的基础概念,以至于我不会在机房座位里面发楞,盯着题目啊吧啊吧。
而且与一年前不同的是,在这段练习的时间当中,我居然大多时候是快乐且充实的,学习(基础的)算法,还挺有趣。此外因为我根据自己的需求深度定制了体验,尽管依旧有少数缺憾,但我也很少为其他琐碎的事情所烦扰,敲着预先准备的一个又一个映射,流畅地像在奏乐,情绪价值也是给满。否则的话,我也不可能有 18/28 天真正在练习。这还像话吗,我的效率能过半?。
虽然说最开始的目的就是为了预推免的机试,同时也为未来潜在的机试练习做基础设施的准备。但我觉得更为宝贵、我从中收获更大的,也许仍是在其中的探索吧。我不断地完善了 Neovim 的配置,一次编辑、一次跳跃,都让我欣喜不已。
也许这和之前很多次没有区别,终究只是在重压之下逃避的自娱自乐之举,但我坚信在这期间分泌的多巴胺不是虚假的,我在其中品尝到的甘甜,与高中折腾时并无差距。只要我依旧可以理解那时候的快乐,那我就可以说我还尚未迷失自我,就可以说我还是那个我。