方差分析、简单线性回归与信息论初步

方差分析

Analysis of Variance (ANOVA)

析因设计/析因分析

Factorial design/Factorial analysis

  • 多个因素会影响实验结果吗?
    • 独立性检验(列联表、Pearson 卡方检验)
  • 不同因素对实验结果的影响如何?是否存在 1+1>21+1>2 的 化学反应?
    • 析因设计、析因分析

单因素方差分析

one-way/single-factor analysis of variance

单个因素的各个水平对实验结果的影响(是否一样?最好?最坏?)

模型假设:

  • mm 个水平,每个水平 nin_i 次试验
  • 正态性:水平 ii 对结果的「效应」(effect)为 μi\mu_i,每次试验有噪声 ϵij∼N(0,σi2)\epsilon_{ij} \sim \mathcal{N}(0, \sigma_i^2),于是 Xij∼N(μi,σi2)X_{ij} \sim \mathcal{N}(\mu_i, \sigma_i^2)
  • 方差齐性:σ12=⋯=σm2=σ2\sigma_1^2 = \dots = \sigma_m^2 = \sigma^2
  • 独立性:噪声之间相互独立

现实中不同实验对象特质不同,明显影响实验结果。

  • 可以使用更大的样本量,随机分组,使得每一组整体看起来都差不多。

分析方差

定义

总离差平方和(total sum of squares)

SST=∑i,j(Xij−Xˉ⊙⊙)2SS_T = \sum_{i, j} (X_{ij} - \bar{X}_{\odot \odot})^2

组内离差平方和(sum of squares within)/误差平方和

SSW=∑i,j(Xij−Xˉi⊙)2SS_W = \sum_{i, j} (X_{ij} - \bar{X}_{i \odot})^2

组间离差平方和(sum of squares between)/效应平方和

SSB=∑ini(Xˉi⊙−Xˉ⊙⊙)2SS_B = \sum_{i} n_i (\bar{X}_{i \odot} - \bar{X}_{\odot \odot})^2

组间离差平方和

直觉上应该有效应 μi≈Xˉi⊙\mu_i \approx \bar{X}_{i \odot},若效应有差距,则 SSBSS_B 会较大。事实上确实有

E[SSB]=E[∑iniXˉi⊙2−nXˉ⊙⊙2]=∑ini[Var⁡[Xˉi⊙]+E[Xˉi⊙]2]−n[Var⁡[Xˉ⊙⊙]+E[Xˉ⊙⊙]2]=∑ini[σ2ni+μi2]−n[σ2n+μˉ2]=(m−1)σ2+∑ini(μi−μˉ)2\begin{aligned} \mathbb{E}[SS_B] &= \mathbb{E}\left[\sum_i n_i \bar{X}_{i \odot}^2 - n \bar{X}_{\odot \odot}^2\right]\\ &= \sum_i n_i \left[ \operatorname{Var} [\bar{X}_{i \odot}] + \mathbb{E}[\bar{X}_{i \odot}]^2 \right] - n \left[ \operatorname{Var} [\bar{X}_{\odot \odot}] + \mathbb{E}[\bar{X}_{\odot \odot}]^2 \right]\\ &= \sum_i n_i \left[ \dfrac{\sigma^2}{n_i} + \mu_i^2 \right] - n \left[ \dfrac{\sigma^2}{n} + \bar{\mu}^2 \right]\\ &= (m-1) \sigma^2 + \sum_i n_i (\mu_i - \bar{\mu})^2 \end{aligned}

若效应相同 μi=μˉ\mu_i = \bar{\mu},则 SSBm−1\dfrac{SS_B}{m - 1} 是方差的无偏估计,且 SSBσ2∼χ2(m−1)\dfrac{SS_B}{\sigma^2} \sim \chi^2(m - 1)(具体可参见上章有关卡方分布的内容)。

组内离差平方和

有 ∑j(Xij−Xˉi⊙)2σ2∼χ2(ni−1)\sum_{j} \dfrac{(X_{ij} - \bar{X}_{i \odot})^2}{\sigma^2}\sim \chi^2(n_i - 1) 且相互独立,于是 SSWσ2∼χ2(n−m)\dfrac{SS_W}{\sigma^2} \sim \chi^2(n - m)。

又 SSBσ2∼χ2(m−1)\dfrac{SS_B}{\sigma^2}\sim \chi^2(m - 1),若要使用 F 检验,还需额外验证 SSB,SSWSS_B, SS_W 相互独立(具体可参见上章的相关内容)。

若效应相同 μi=μˉ\mu_i = \bar{\mu},则 SSB/(m−1)SSW/(n−m)∼F(m−1,n−m)\dfrac{SS_B / (m - 1)}{SS_W / (n - m)} \sim F(m - 1, n - m)。

方差来源 平方和 自由度 均方(MS) FF 比率
因素 SSBSS_B m−1m - 1 MSB=SSBm−1MS_B = \dfrac{SS_B}{m - 1} F=MSBMSWF = \dfrac{MS_B}{MS_W}
误差 SSWSS_W n−mn - m MSW=SSWn−mMS_W = \dfrac{SS_W}{n - m}
总和 SSTSS_T n−1n - 1 -

快捷计算*

令 Ti=∑jXij,T=∑iTiT_i = \sum_{j} X_{ij}, T = \sum_i T_i,则有

{SST=∑i,jXij2−T2nSSB=∑iTi2ni−T2nSSW=SST−SSB\left\lbrace\begin{aligned} SS_T &= \sum_{i, j} X_{ij}^2 - \dfrac{T^2}{n}\\ SS_B &= \sum_i \dfrac{T_i^2}{n_i} - \dfrac{T^2}{n}\\ SS_W &= SS_T - SS_B \end{aligned}\right.

最后一个证明有

SST=∑i,j(Xij−Xˉ⊙⊙)2=∑i,j(Xij−Xˉi⊙+Xˉi⊙−Xˉ⊙⊙)2=∑i,j(Xij−Xˉi⊙)2+∑i,j(Xˉi⊙−Xˉ⊙⊙)2+2∑i,j(Xij−Xˉi⊙)(Xˉi⊙−Xˉ⊙⊙)=SSW+SSB+2∑i,j(Xij−Xˉi⊙)(Xˉi⊙−Xˉ⊙⊙)=SSW+SSB+2∑i(Xˉi⊙−Xˉ⊙⊙)∑j(Xij−Xˉi⊙)=SSW+SSB+2∑i(Xˉi⊙−Xˉ⊙⊙)×0=SSW+SSB\begin{aligned} SS_T &= \sum_{i, j} (X_{ij} - \bar{X}_{\odot \odot})^2\\ &= \sum_{i, j} (X_{ij} - \bar{X}_{i \odot} + \bar{X}_{i \odot} - \bar{X}_{\odot \odot})^2\\ &= \sum_{i, j} (X_{ij} - \bar{X}_{i \odot})^2 + \sum_{i, j} (\bar{X}_{i \odot} - \bar{X}_{\odot \odot})^2 + 2 \sum_{i, j} (X_{ij} - \bar{X}_{i \odot})(\bar{X}_{i \odot} - \bar{X}_{\odot \odot})\\ &= SS_W + SS_B + 2 \sum_{i, j} (X_{ij} - \bar{X}_{i \odot})(\bar{X}_{i \odot} - \bar{X}_{\odot \odot})\\ &= SS_W + SS_B + 2 \sum_i (\bar{X}_{i \odot} - \bar{X}_{\odot \odot}) \sum_j (X_{ij} - \bar{X}_{i \odot})\\ &= SS_W + SS_B + 2 \sum_i (\bar{X}_{i \odot} - \bar{X}_{\odot \odot}) \times 0\\ &= SS_W + SS_B \end{aligned}

参数估计

若效应不同,估计效应 μi\mu_i

采用最大似然估计

L(μ1,…,μm,σ2)=(12πσ2)nexp⁡(−∑i⩽m∑j⩽ni(Xij−μi)22σ2)L(\mu_1, \dots, \mu_m, \sigma^2) = \left( \dfrac{1}{\sqrt{2\pi\sigma^2}} \right)^n \exp\left( -\sum_{i\le m}\sum_{j \le n_i} \dfrac{(X_{ij} - \mu_i)^2}{2 \sigma^2} \right)

估计方差

无关因素,组内离差平方和 SSWσ2∼χ2(n−m)\dfrac{SS_W}{\sigma^2} \sim \chi^2(n - m)。

估计两个水平下的总体 N(μi,σ2), N(μj,σ2)\mathcal{N}(\mu_i, \sigma^2),\, \mathcal{N}(\mu_{j}, \sigma^2) 的效应差 μi−μj\mu_i - \mu_{j}

有

  • E[Xˉi⊙−Xˉj⊙]=μi−μj\mathbb{E}[\bar{X}_{i \odot} - \bar{X}_{j \odot}] = \mu_i - \mu_{j}
  • Var⁡[Xˉi⊙−Xˉj⊙]=σ2(1ni=1nj)\operatorname{Var} [\bar{X}_{i \odot} - \bar{X}_{j \odot}] = \sigma^2\left(\frac{1}{n_i} = \frac{1}{n_{j}}\right)

于是有

(Xˉi⊙−Xˉj⊙)−(μi−μj)σ1ni+1nj/SSWσ2/(n−m)=(Xˉi⊙−Xˉj⊙)−(μi−μj)SSW(1ni+1nj)/(n−m)∼t(n−m)\dfrac{(\bar{X}_{i \odot} - \bar{X}_{j \odot}) - (\mu_i - \mu_{j})}{\sigma \sqrt{\frac{1}{n_i} + \frac{1}{n_{j}}}} \bigg/ \sqrt{\dfrac{SS_W}{\sigma^2} / (n - m)} = \dfrac{(\bar{X}_{i \odot} - \bar{X}_{j \odot}) - (\mu_i - \mu_{j})}{\sqrt{SS_W(\frac{1}{n_i} + \frac{1}{n_{j}}) / (n - m)}} \sim t(n - m)

双因素方差分析

two-way analysis of variance

两个因素的各个水平对实验结果的影响(是否一样?最好?最坏?)

模型假设:

  • a,ba, b 个水平,每个水平组合一次试验
  • 线性:Xij=μ+αi+βj+ϵijX_{ij} = \mu + \alpha_i + \beta_{j} + \epsilon_{ij}
  • 正态性:每次试验噪声 ϵij∼N(0,σi2)\epsilon_{ij} \sim \mathcal{N}(0, \sigma_i^2)
  • 方差齐性:σ12=⋯=σm2=σ2\sigma_1^2 = \dots = \sigma_{m}^2 = \sigma^2
  • 独立性:噪声之间相互独立

分析方差

定义

总离差平方和

SST=∑i,j(Xij−Xˉ⊙⊙)2SS_T = \sum_{i, j} (X_{ij} - \bar{X}_{\odot \odot})^2

因素 A 的效应平方和

SSA=b∑i⩽a(Xˉi⊙−Xˉ⊙⊙)2SS_A = b \sum_{i \le a} (\bar{X}_{i \odot} - \bar{X}_{\odot \odot})^2

因素 B 的效应平方和

SSB=a∑j⩽b(Xˉ⊙j−Xˉ⊙⊙)2SS_B = a \sum_{j \le b} (\bar{X}_{\odot j} - \bar{X}_{\odot \odot})^2

误差平方和

SSE=∑i,j(Xij−Xˉi⊙−Xˉ⊙j+Xˉ⊙⊙)2SS_E = \sum_{i, j} (X_{ij} - \bar{X}_{i \odot} - \bar{X}_{\odot j} + \bar{X}_{\odot \odot})^2

假设检验

直觉上因素各水平的效应都相同的话有 αi=0\alpha_i = 0 或 βi=0\beta_i = 0,效应平方和不会大:

  • 若因素 A 效应相同 αi=0\alpha_i = 0,SSAσ2∼χ(α−1)\dfrac{SS_A}{\sigma^2}\sim \chi(\alpha - 1),否则 E[SSA/(a−1)]>σ2\mathbb{E}\left[ SS_A / (a - 1) \right] > \sigma^2
  • 若因素 B 效应相同 βi=0\beta_i = 0,SSBσ2∼χ(β−1)\dfrac{SS_B}{\sigma^2}\sim \chi(\beta - 1),否则 E[SSB/(b−1)]>σ2\mathbb{E}\left[ SS_B / (b - 1) \right] > \sigma^2

无关因素,误差平方和 SSEσ2∼χ2((a−1)(b−1))\dfrac{SS_E}{\sigma^2} \sim \chi^2((a - 1)(b - 1))。

  • 检验因素 A

FA=SSA/(a−1)SSE/((a−1)(b−1))F_A = \dfrac{SS_A / (a - 1)}{SS_E / ((a - 1)(b - 1))}

  • 检验因素 B

FB=SSB/(b−1)SSE/((a−1)(b−1))F_B = \dfrac{SS_B / (b - 1)}{SS_E / ((a - 1)(b - 1))}

方差分析表

方差来源 平方和 自由度 均方(MS) FF 比率
因素 A SSASS_A a−1a - 1 MSA=SSAa−1MS_A = \dfrac{SS_A}{a - 1} F=MSAMSEF = \dfrac{MS_A}{MS_E}
因素 B SSBSS_B b−1b - 1 MSB=SSBb−1MS_B = \dfrac{SS_B}{b - 1} F=MSBMSEF = \dfrac{MS_B}{MS_E}
误差 SSESS_E (a−1)(b−1)(a - 1)(b - 1) MSE=SSE(a−1)(b−1)MS_E = \dfrac{SS_E}{(a - 1)(b - 1)} -
总和 SSTSS_T ab−1ab - 1 - -

双因素方差分析和交互作用(interaction)

模型假设:

  • a,ba, b 个水平,每个水平组合 cc 次试验
  • 线性:Xij=μ+αi+βj+γij+ϵijX_{ij} = \mu + \alpha_i + \beta_{j} + \textcolor{ff0099}{\gamma_{ij}} + \epsilon_{ij},γij\gamma_{ij} 为交互作用效应
  • 正态性:每次试验噪声 ϵij∼N(0,σi2)\epsilon_{ij} \sim \mathcal{N}(0, \sigma_i^2)
  • 方差齐性:σ12=⋯=σm2=σ2\sigma_1^2 = \dots = \sigma_{m}^2 = \sigma^2
  • 独立性:噪声之间相互独立

分析方差

定义

总离差平方和

SST=∑i,j,k(Xijk−Xˉ⊙⊙⊙)2SS_T = \sum_{i, j, k} (X_{ijk} - \bar{X}_{\odot \odot \odot})^2

因素 A 的效应平方和

SSA=bc∑i(Xˉi⊙⊙−Xˉ⊙⊙⊙)2SS_A = b c \sum_{i} (\bar{X}_{i \odot \odot} - \bar{X}_{\odot \odot \odot})^2

因素 B 的效应平方和

SSB=ac∑j(Xˉ⊙j⊙−Xˉ⊙⊙⊙)2SS_B = a c \sum_{j} (\bar{X}_{\odot j \odot} - \bar{X}_{\odot \odot \odot})^2

交互作用的效应平方和

SSAB=c∑i,j(Xˉij⊙−Xˉi⊙⊙−Xˉ⊙j⊙+Xˉ⊙⊙⊙)2SS_{AB} = c \sum_{i, j} (\bar{X}_{ij \odot} - \bar{X}_{i \odot \odot} - \bar{X}_{\odot j \odot} + \bar{X}_{\odot \odot \odot})^2

误差平方和

SSE=∑i,j,k(Xijk−Xˉij⊙)2SS_E = \sum_{i, j, k} (X_{ijk} - \bar{X}_{ij \odot})^2

假设检验

直觉上若交互作用不存在,则 Xˉij⊙≈Xˉi⊙⊙+Xˉ⊙j⊙−Xˉ⊙⊙⊙\bar{X}_{ij \odot} \approx \bar{X}_{i \odot \odot}+ \bar{X}_{\odot j \odot} - \bar{X}_{\odot \odot \odot} 且 γij≈0\gamma_{ij} \approx 0,效应平方和不会大。

若没有交互作用,γij=0\gamma_{ij} = 0,有 SSABσ2∼χ2((a−1)(b−1))\dfrac{SS_{AB}}{\sigma^2} \sim \chi^2((a - 1)(b - 1)),否则 E[SSAB(a−1)(b−1)]>σ2\mathbb{E}\left[ \frac{SS_{AB}}{(a - 1)(b - 1)} \right] > \sigma^2

无关因素,误差平方和 SSEσ2∼χ2(ab(c−1))\dfrac{SS_E}{\sigma^2} \sim \chi^2(ab (c - 1))。

检验交互作用

FAB=SSAB/((a−1)(b−1))SSE/(ab(c−1))∼F((a−1)(b−1),ab(c−1))F_{AB} = \dfrac{SS_{AB} / ((a - 1)(b - 1))}{SS_E / (ab (c - 1))} \sim F((a - 1)(b - 1), ab(c - 1))

方差分析表

方差来源 平方和 自由度 均方(MS) FF 比率
因素 A SSASS_A a−1a - 1 MSA=SSAa−1MS_A = \dfrac{SS_A}{a - 1} F=MSAMSEF = \dfrac{MS_A}{MS_E}
因素 B SSBSS_B b−1b - 1 MSB=SSBb−1MS_B = \dfrac{SS_B}{b - 1} F=MSBMSEF = \dfrac{MS_B}{MS_E}
交互作用 SSABSS_{AB} (a−1)(b−1)(a - 1)(b - 1) MSAB=SSAB(a−1)(b−1)MS_{AB} = \dfrac{SS_{AB}}{(a - 1)(b - 1)} F=MSABMSEF = \dfrac{MS_{AB}}{MS_E}
误差 SSESS_E ab(c−1)ab(c - 1) MSE=SSEab(c−1)MS_E = \dfrac{SS_E}{ab(c - 1)} -
总和 SSTSS_T abc−1abc - 1 - -

快捷计算*

令

  • Tij=∑kXijkT_{ij} = \sum_{k} X_{ijk}
  • Ti⊙=∑jTijT_{i \odot} = \sum_{j} T_{ij}
  • T⊙j=∑iTijT_{\odot j} = \sum_{i} T_{ij}
  • T=∑i,jTijT = \sum_{i, j} T_{ij}

则有

{SST=∑i,j,kXijk2−T2abcSSA=∑iTi⊙2ac−T2abcSSB=∑jT⊙j2bc−T2abcSSAB=∑i,jTij2c−T2abc−SA−SBSSE=SST−SSA−SSB−SSAB\left\lbrace\begin{aligned} SS_T &= \sum_{i, j, k} X_{ijk}^2 - \dfrac{T^2}{abc}\\ SS_A &= \sum_{i} \dfrac{T_{i \odot}^2}{ac} - \dfrac{T^2}{abc}\\ SS_B &= \sum_{j} \dfrac{T_{\odot j}^2}{bc} - \dfrac{T^2}{abc}\\ SS_{AB} &= \sum_{i, j} \dfrac{T_{ij}^2}{c} - \dfrac{T^2}{abc} - S_A - S_B\\ SS_E &= SS_T - SS_A - SS_B - SS_{AB} \end{aligned}\right.

回归

由于其他笔记,例如《机器学习》已涉及相关内容,这里就不完整记录了。

线性回归

模型假设:

  • 规律符合线性
  • 噪声正态性、齐性、独立性:ϵi∼N(0,σ2)\epsilon_i \sim \mathcal{N}(0, \sigma^2)

参数估计

简单线性回归 Yi=a+bXi+ϵiY_i = a + b X_i + \epsilon_i。

模型有多好?如何选择 a,ba, b?

最大似然估计(LME):

L(a,b,σ2)=(12πσ2)nexp⁡(−12σ2∑i(yi−a−bxi))L(a, b, \sigma^2) = \left( \dfrac{1}{\sqrt{2 \pi \sigma^2}} \right)^n \exp\left( -\dfrac{1}{2 \sigma^2} \sum_i (y_i - a - b x_i) \right)

即最小化 ∑i(yi−a−bxi)2\sum_i (y_i - a - b x_i)^2,这也就是「最小二乘法」(least squares)。

相当于求驻点

{2∑i(yi−a−bxi)=02∑i(yi−a−bxi)xi=0\left\lbrace\begin{aligned} 2 \sum_i (y_i - a - b x_i) &= 0\\ 2 \sum_i (y_i - a - b x_i) x_i &= 0 \end{aligned}\right.

解得

{∑iyi=na+b∑ixi∑ixiyi=a∑ixi+b∑ixi2\left\lbrace\begin{aligned} \sum_i y_i = n a + b \sum_i x_i\\ \sum_i x_i y_i = a \sum_i x_i + b \sum_i x_i^2 \end{aligned}\right.

剩下的解方程组即可。

估计方差

估计 y^i=a^+b^xi\hat{y}_i = \hat{a} + \hat{b} x_i 会有偏差。

  • 残差(residual):ei=y^i−yie_i = \hat{y}_i - y_i
  • 残差平方和 Q=∑iei2Q = \sum_i e_i^2

有

  • Qσ2∼χ2(n−2)\dfrac{Q}{\sigma^2} \sim \chi^2(n - 2)
  • E[Qn−2]=σ2\mathbb{E}\left[ \dfrac{Q}{n - 2} \right] = \sigma^2

点预测与预测区间

简单线性回归 Y=a+bX+ϵY = a + b X + \epsilon,给定 XX 预测 YY 误差永远存在,精确估计不现实。

  • 预测关于 X1,…,XnX_1, \dots, X_n 的 Y1,…,YnY_1, \dots, Y_n 的平均值,大数定理保证了 nn 越大估计越精确
  • 预测区间:给定 XX,预测 YY 可能的范围

控制问题:给定 YY 以 1−α1 - \alpha 概率处于范围 [yL,yU][y_L, y_U],则 XX 应该是多少?

其他话题

拟合优度

判定系数(coefficient of determination)R∈[0,1]R \in [0, 1]

令

SST=∑i(yi−yˉ)2=∑i(y^i−yˉ)2+∑i(yi−y^i)2=SSR+SSE\begin{aligned} SS_T &= \sum_i (y_i - \bar{y})^2\\ &= \sum_i (\hat{y}_i - \bar{y})^2 + \sum_i (y_i - \hat{y}_i)^2\\ &= SS_R + SS_E \end{aligned}

于是有

R2=SSRSSTR^2 = \dfrac{SS_R}{SS_T}

线性回归的方差分析

方差来源 平方和 自由度 均方(MS) FF 比率
回归 SSRSS_R 1 MSR=SSRMS_R = SS_R F=MSRMSEF = \dfrac{MS_R}{MS_E}
残差 SSESS_E n−2n - 2 MSE=SSEn−2MS_E = \dfrac{SS_E}{n - 2}
总和 SSTSS_T n−1n - 1 - -

异常值(离群值,outlier)

少数离群值对均方误差贡献极大,普通最小二乘对此非常敏感。

非线性回归

见《机器学习》相关笔记,此处略。

  • 对数线性回归
  • Logistic 回归
  • 支持向量回归
  • 岭回归

过拟合

见《机器学习》相关笔记,此处略。

多元线性回归

yi=β0+β1xi1+⋯+βpxip+ϵi=xi⊺β+ϵiy_i = \beta_0 + \beta_1 x_{i 1}+ \dots + \beta_p x_{i p} + \epsilon_i = \mathbf{x}_i^\intercal \bm{\beta} + \epsilon_i

令

y=[y1⋮yn], X=[x1⊺⋮xn⊺]=[1x11…x1p⋮⋮⋱⋮1xn1…xnp], β=[β0⋮βp], ϵ=[ϵ1⋮ϵn]\mathbf{y} = \begin{bmatrix} y_1 \\ \vdots \\ y_n \end{bmatrix},\, \mathbf{X} = \begin{bmatrix} \mathbf{x}_1^\intercal \\ \vdots \\ \mathbf{x}_n^\intercal \end{bmatrix} = \begin{bmatrix} 1 & x_{11} & \dots & x_{1 p}\\ \vdots & \vdots & \ddots & \vdots\\ 1 & x_{n1} & \dots & x_{n p} \end{bmatrix},\, \bm{\beta} = \begin{bmatrix} \beta_0 \\ \vdots \\ \beta_p \end{bmatrix},\, \bm{\epsilon} = \begin{bmatrix} \epsilon_1 \\ \vdots \\ \epsilon_n \end{bmatrix}

则有

y=Xβ+ϵ\mathbf{y} = \mathbf{X} \bm{\beta} + \bm{\epsilon}

则参数

β^=arg min⁡β∥y−Xβ∥2≈(X⊺X)−1X⊺y\hat{\bm{\beta}} = \argmin_{\bm{\beta}} \left\lVert \mathbf{y} - \mathbf{X} \bm{\beta} \right\rVert_2 \approx (\mathbf{X}^\intercal \mathbf{X})^{-1} \mathbf{X}^\intercal \mathbf{y}

高维空间最优化问题,较为复杂。

信息论初步

信息熵

信息熵(entropy)刻画变量「有多随机」

H(X)=∑xp(x)log⁡21p(x)H(X) = \sum_x p(x) \log_2 \dfrac{1}{p(x)}

底数不一定是 22。

这个定义是从公理导出的*:

  • 对称性:H(p1,p2,… )=H(p2,p1,… )H(p_1, p_2, \dots) = H(p_2, p_1, \dots)
  • 最大熵:H(p1,…,pn)⩽H(1n,…,1n)=log⁡nH(p_1, \dots, p_n) \le H\left(\frac{1}{n}, \dots, \frac{1}{n}\right) = \log n
  • 连续性
  • 递归性:H(p1,p2,…,pn)=H(p1+p2,…,pn)+(p1+p2)H(p1p1+p2,p2p1+p2)H(p_1, p_2, \dots, p_n) = H(p_1 + p_2, \dots, p_n) + (p_1 + p_2) H\left(\frac{p_1}{p_1 + p_2}, \frac{p_2}{p_1 + p_2}\right)

信息熵简单的性质:

  • 非负性:对任意随机变量 XX 都有 H(X)⩾0H(X) \ge 0
  • 可加性:若 X,YX, Y 相互独立,则联合分布 H(X,Y)=H(X)+H(Y)H(X, Y) = H(X) + H(Y)

第一个显然,第二个有

H(X,Y)=−∑x,yp(x,y)log⁡2p(x,y)=−∑x,yp(x)p(y)(log⁡2p(x)+log⁡2p(y))=−(∑yp(y))∑xp(x)log⁡2p(x)−(∑xp(x))∑yp(y)log⁡2p(y)=−∑xp(x)log⁡2p(x)−∑yp(y)log⁡2p(y)=H(X)+H(Y)\begin{aligned} H(X, Y) &= - \sum_{x, y} p(x, y) \log_2 p(x, y)\\ &= - \sum_{x, y} p(x) p(y) (\log_2 p(x) + \log_2 p(y))\\ &= - \left( \sum_y p(y) \right) \sum_x p(x) \log_2 p(x) - \left( \sum_x p(x) \right) \sum_y p(y) \log_2 p(y)\\ &= - \sum_x p(x) \log_2 p(x) - \sum_y p(y) \log_2 p(y)\\ &= H(X) + H(Y) \end{aligned}

若 nq∈[0,n]nq \in [0, n] 是整数,则

2nH(q)n+1⩽(nnq)⩽2nH(q)\dfrac{2^{n H(q)}}{n + 1} \le \dbinom{n}{nq} \le 2^{n H(q)}

证明

上界由二项式定理有

1=(q+(1−q))n=∑k=0n(nk)qk(1−q)n−k⩾(nnq)qnq(1−q)n−nq\begin{aligned} 1 &= (q + (1 - q))^n\\ &= \sum_{k=0}^{n} \dbinom{n}{k} q^{k} (1 - q)^{n - k}\\ &\ge \dbinom{n}{nq} q^{nq} (1 - q)^{n - nq}\\ \end{aligned}

从而

(nnq)⩽q−qn(1−q)−(1−q)n=2−qnlog⁡2q2−(1−q)nlog⁡2(1−q)=2nH(q)\begin{aligned} \dbinom{n}{nq} &\le q^{-q n} (1 - q)^{-(1 - q) n}\\ &= 2^{-q n \log_2 q} 2^{-(1 - q) n \log_2 (1 - q)}\\ &= 2^{n H(q)} \end{aligned}

下界有 nq=arg min⁡k(nk)qk(1−q)n−kn q = \argmin\limits_{k} \binom{n}{k} q^{k} (1 - q)^{n - k},二项式定理有

∑k=0n(nk)qk(1−q)n−k=1\sum_{k=0}^{n} \dbinom{n}{k} q^{k} (1 - q)^{n - k} = 1

最多含 n+1n + 1 项。

于是

(n+1)(nnq)qqn(1−q)(1−q)n⩾1(n + 1) \dbinom{n}{n q} q^{q n} (1 - q)^{(1 - q) n} \ge 1

等价于

(nnq)⩾qqn(1−q)(1−q)nn+1⩾2nH(q)n+1\begin{aligned} \dbinom{n}{n q} &\ge \dfrac{q^{qn}(1 - q)^{(1 - q)n}}{n + 1}\\ &\ge \dfrac{2^{n H(q)}}{n + 1} \end{aligned}

目标 q=arg min⁡k(nk)qk(1−q)n−kq = \argmin\limits_{k} \binom{n}{k} q^{k} (1 - q)^{n - k},于是

(nk)qk(1−q)n−k−(nk+1)qk+1(1−q)n−k−1=(nk)qk(1−q)n−k(1−n−kk+1q1−q)\dbinom{n}{k} q^{k} (1 - q)^{n - k} - \dbinom{n}{k + 1} q^{k + 1} (1 - q)^{n - k - 1} = \dbinom{n}{k} q^{k} (1 - q)^{n - k} \left( 1 - \dfrac{n - k}{k + 1} \dfrac{q}{1 - q} \right)

非负,当 1−n−kk+1q1−q⩾01 - \dfrac{n - k}{k + 1} \dfrac{q}{1 - q} \ge 0。

而这等价于

k⩾qn−1+qk \ge q n - 1 + q

压缩

硬币序列

压缩方案即前缀码 f ⁣:Ωn→{0,1}∗f\colon \Omega^n \to \left\lbrace 0, 1 \right\rbrace^{*}。

一枚硬币正面概率 p>12p > \dfrac{1}{2},对任意小的常数 δ>0\delta > 0,nn 足够大时有

  • 存在一种压缩使用期望至多 (1+δ)nH(p)(1 + \delta) n H(p) 个比特压缩长度 nn 的抛硬币序列
  • 任意压缩长度 nn 的抛硬币序列的压缩方案使用期望至少 (1−δ)nH(p)(1 - \delta) n H(p) 个比特

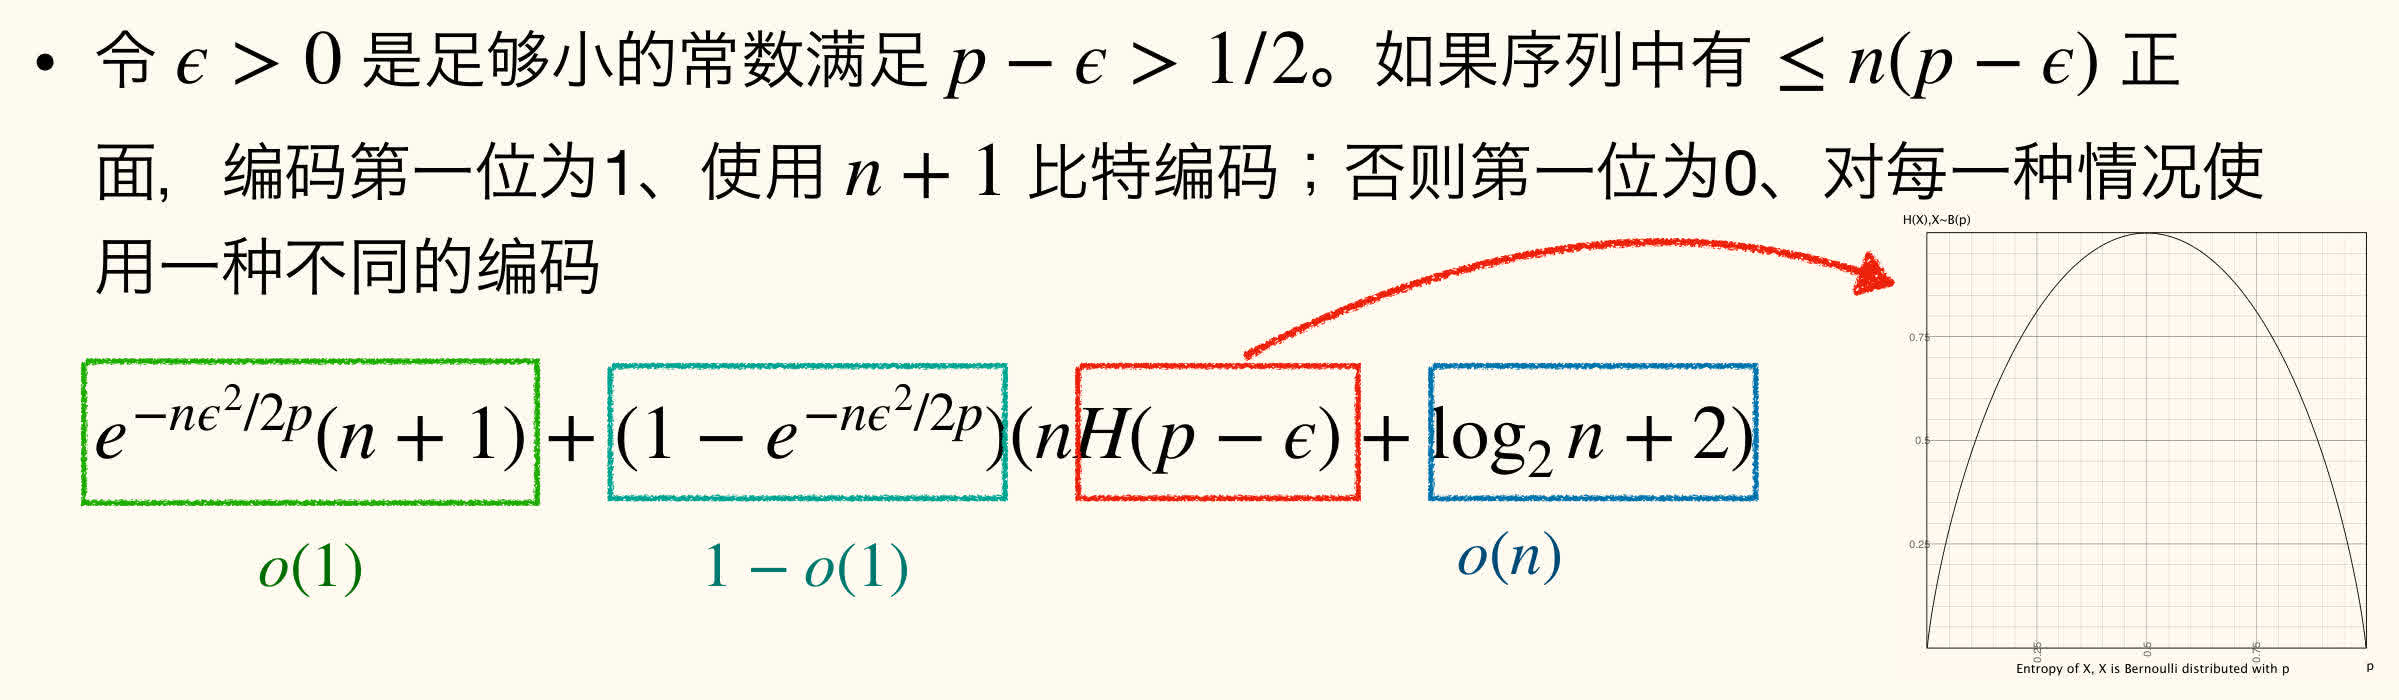
令 ϵ>0\epsilon > 0 是足够小的常数满足 p−ϵ>12p - \epsilon > \dfrac{1}{2}。

  • 若序列中有不多于 n(p−ϵ)n(p - \epsilon) 正面:编码第一位为 11,使用 n+1n + 1 比特编码;
  • 否则第一位为 00,对每一种情况使用一种不同的编码(如 mm 种序列 ⌈log⁡2m⌉\left\lceil \log_2 m \right\rceil 比特)

第一种情况由 Chernoff 界,概率不超过 exp⁡(−nϵ22p)\exp\left(\dfrac{- n \epsilon^2}{2 p}\right),全期望 (n+1)exp⁡(nϵ22p)(n + 1) \exp\left( \dfrac{n \epsilon^2}{2 p} \right)。

第二种情况数目

∑i=n(p−ϵ)n(ni)⩽∑i=n(p−ϵ)n(nn(p−ϵ))⩽n22nH(p−ϵ)\begin{aligned} \sum_{i=n(p-\epsilon)}^{n} \dbinom{n}{i} &\le \sum_{i=n(p - \epsilon)}^{n} \dbinom{n}{n(p - \epsilon)}\\ &\le \dfrac{n}{2} 2^{n H(p - \epsilon)} \end{aligned}

使用比特

1+⌈log⁡2n22nH(p−ϵ)⌉⩽nH(p−ϵ)+log⁡2n+21 + \left\lceil \log_2 \dfrac{n}{2} 2^{n H(p - \epsilon)} \right\rceil \le n H(p - \epsilon) + \log_2 n + 2

若序列 S1S_1 比序列 S2S_2 出现概率更高,则最优压缩方案满足

∣f(S1)∣⩽∣f(S2)∣|f(S_1)| \le |f(S_2)|

对于任意大小为 ss 的序列的集合,一定有一个序列 SS 满足

∣f(S)∣⩾log⁡2s−1|f(S)| \ge \log_2 s - 1

则包含 n(p+ϵ)n(p + \epsilon) 个正面的序列需要 log⁡2(nn(p+ϵ))−1⩾log⁡22nH(p+ϵ)n+1−1\log_2 \dbinom{n}{n(p + \epsilon)} - 1 \ge \log_2 \dfrac{2^{n H(p + \epsilon)}}{n + 1} - 1 个比特。

香农信源编码定理*

source coding theorem

对压缩方案前缀码 f ⁣:Ωn→{0,1}∗f\colon \Omega^n \to \left\lbrace 0, 1 \right\rbrace^{*},对于任意在 Ω\Omega 上的概率分布 DD,对于足够大的 nn 有:

  • 任意压缩方案都不可能使用期望低于 nH(D)n H(D) 个比特压缩 (X1,…,Xn)∼D(X_1, \dots, X_n) \sim D
  • 存在一种压缩方案使用期望少于 nH(D)+1n H(D) + 1 个比特压缩 (X1,…,Xn)∼D(X_1, \dots, X_n) \sim D

对于 x∈Ωx \in \Omega,使用长度为 ⌈−log⁡2D(x)⌉⩽−log⁡2D(x)+1\left\lceil - \log_2 D(x) \right\rceil \le - \log_2 D(x) + 1 个比特的编码,期望长度不超过 ∑xD(x)(−log⁡2D(x)+1)=H(X)=1\displaystyle \sum_x D(x) (- \log_2 D(x) + 1) = H(X) = 1。